Técnica de memória põe LLM de 29M de parâmetros num simples ESP32
Um programador enfiou um modelo de linguagem com 28,9 milhões de parâmetros num ESP32-S3. Sem cloud, sem truques, só gestão de memória à la Gemma e muita teimosia.
Um programador enfiou um modelo de linguagem com 28,9 milhões de parâmetros num ESP32-S3. Sem cloud, sem truques, só gestão de memória à la Gemma e muita teimosia.
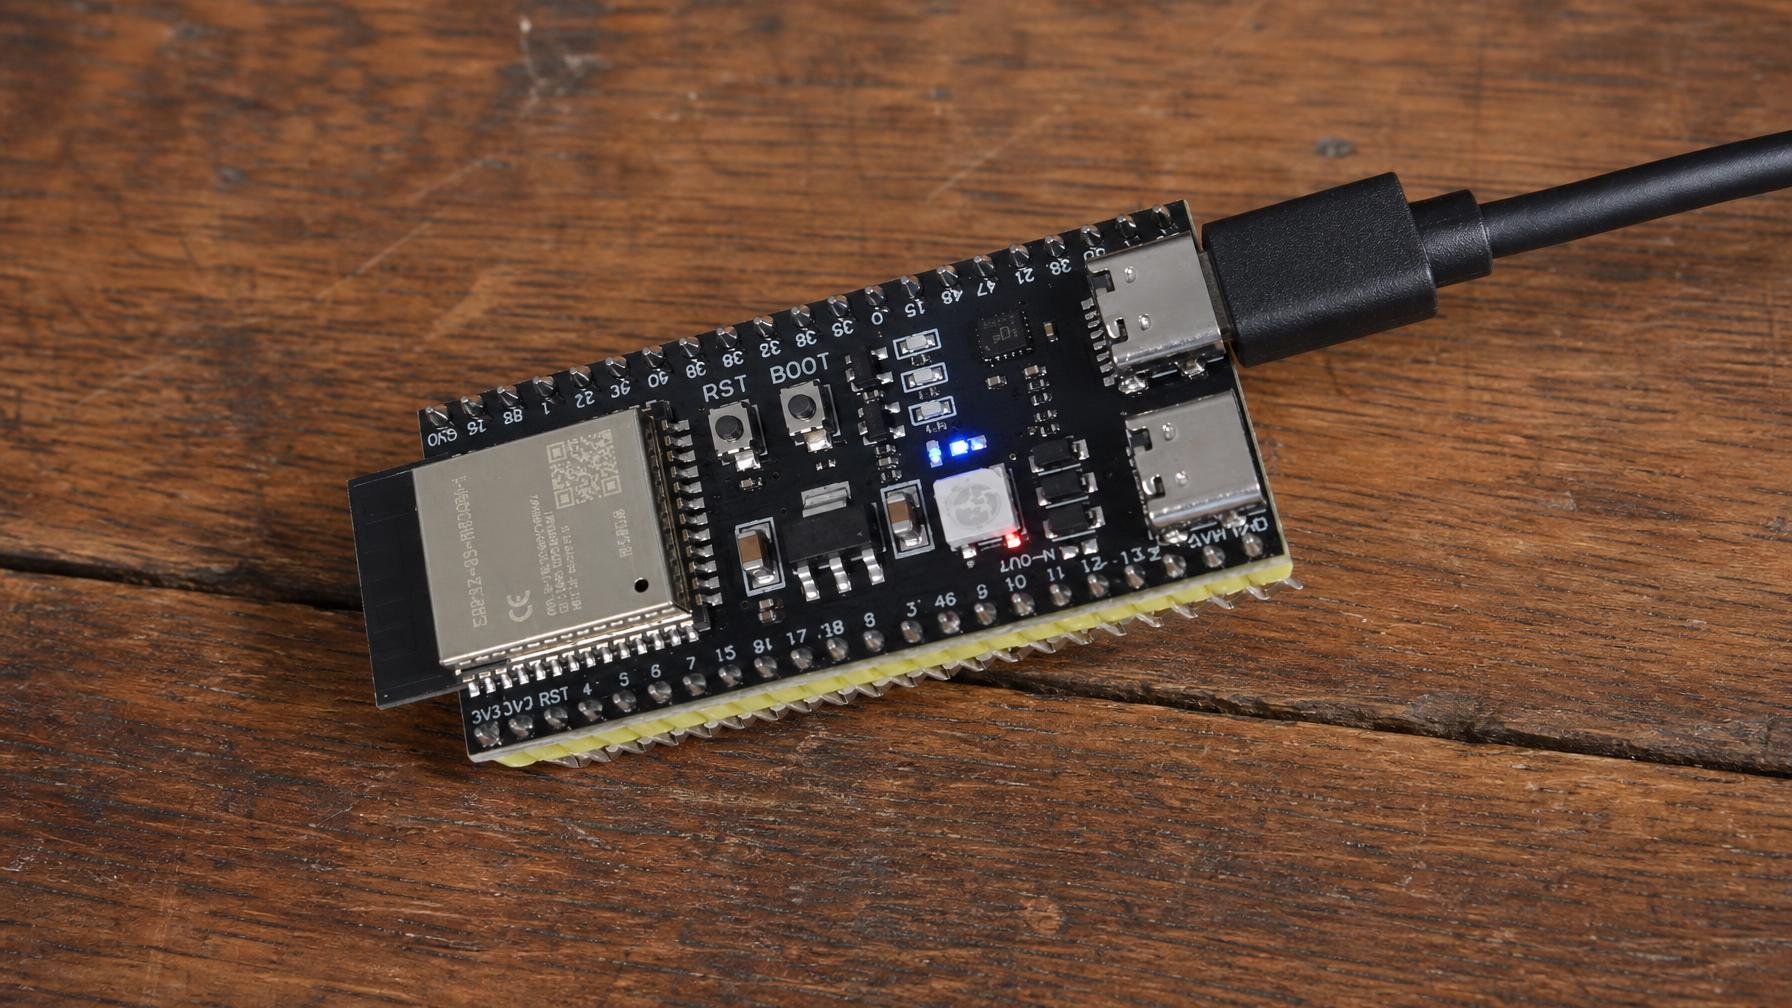
Um ESP32-S3 a debitar texto de um modelo com 28,9 milhões de parâmetros parece conversa de apresentação de slides. Aqui não há palco nem GPU, há um microcontrolador barato com 16 MB de flash, 512 KB de SRAM e 8 MB de PSRAM a correr um LLM totalmente offline. O truque não é magia, é gestão de memória inspirada nos modelos Gemma da Google.
O projecto usa Per-Layer Embeddings, uma técnica de alocação de memória em que a tabela de embeddings deixa de ser um monstro residente em RAM e passa a ser fatiada. Cerca de 25 milhões de parâmetros vivem na flash de 16 MB do ESP32-S3, enquanto o “miolo” do modelo ocupa a SRAM. Durante a geração de tokens só é carregado o pedaço da embedding table que está a ser usado, por isso a latência da flash, mais lenta, não mata o desempenho. Resultado: cerca de 9,5 tokens por segundo num microcontrolador que costumamos ver a piscar LEDs e a ler sensores.
Para caber tudo, o modelo é quantizado para 4 bits, encolhendo para perto de 14,9 MB. A PSRAM de 8 MB fica responsável pela memória de trabalho e pelo pós-processamento da saída. Isto não é apenas um truque académico. É um manual de instruções para quem anda a espremer IA em dispositivos de borda: se aceitares quantização agressiva e arquitectura pensada para hierarquias de memória, de repente o teu “limite físico” deixa de ser tão rígido.
Há, claro, compromissos. O modelo foi treinado no dataset TinyStories, é bom a inventar historinhas curtas, não é um assistente generalista nem está pronto para tomar conta do teu projecto industrial. Não responde a perguntas nem faz raciocínio complexo. Mas a função aqui não é competir com GPT-4, é mostrar que redes bem maiores do que o habitual podem viver em hardware minúsculo. Quem anda a pensar em sensores industriais, contadores inteligentes ou dispositivos médicos com IA embebida devia estar a tirar notas.
Em Portugal, onde um ESP32-S3 comprado na Amazon ES ou numa loja de electrónica custa menos do que um jantar decente, isto abre outra conversa: a de fazer protótipos de edge AI realmente privados. Dados que nunca saem do dispositivo, sem subscrições de cloud, sem debitar dados sensíveis para servidores que não controlas. É um contraponto curioso ao mundo dos grandes modelos alojados em datacenters, como o investimento da MediaTek em chips de IA para centros de dados que já analisámos em detalhe em chips de IA em datacenters.
O código está em open source, o que significa que qualquer pessoa pode espreitar a implementação de embeddings por camada, copiar, criticar e melhorar. A mensagem aqui é simples: o limite da IA em microcontroladores não está só no silício, está na imaginação de quem desenha a arquitectura. E quem continuar a pensar que “IA” é sinónimo de cloud e GPU de topo arrisca-se a ser apanhado de surpresa quando um simples ESP32 no quadro eléctrico começar a tomar decisões por conta própria.
Fonte: Open Source For You

Os primeiros Nest Learning Thermostat perderam funções ligadas à cloud em 2025 e ficaram reduzidos ao básico. Um projeto open source devolve-lhes agendamento remoto, integrações e um pouco…

A fuga não é só por causa da IA do Copilot. Há uma lista crescente de queixas e alternativas maduras para onde comunidades inteiras estão a migrar.

Mapas de divisão, câmaras, microfones e cloud transformaram os aspiradores‑robô em sensores ambulantes. O problema não é só técnico, é de modelo de negócio e de políticas de…

Os novos óculos inteligentes da HTC fazem quase o mesmo que os de Meta, mas trocam a sede de dados por limites claros: IA sem login, vídeos cifrados…
Comentários · 0