Marlin, o motor de busca caseiro para quem já se cansou do Google
Um programador montou um índice de 560 mil sites com IA barata e código aberto. A parte difícil não foi a GPU, foi domar o caos das categorias.
Um programador montou um índice de 560 mil sites com IA barata e código aberto. A parte difícil não foi a GPU, foi domar o caos das categorias.
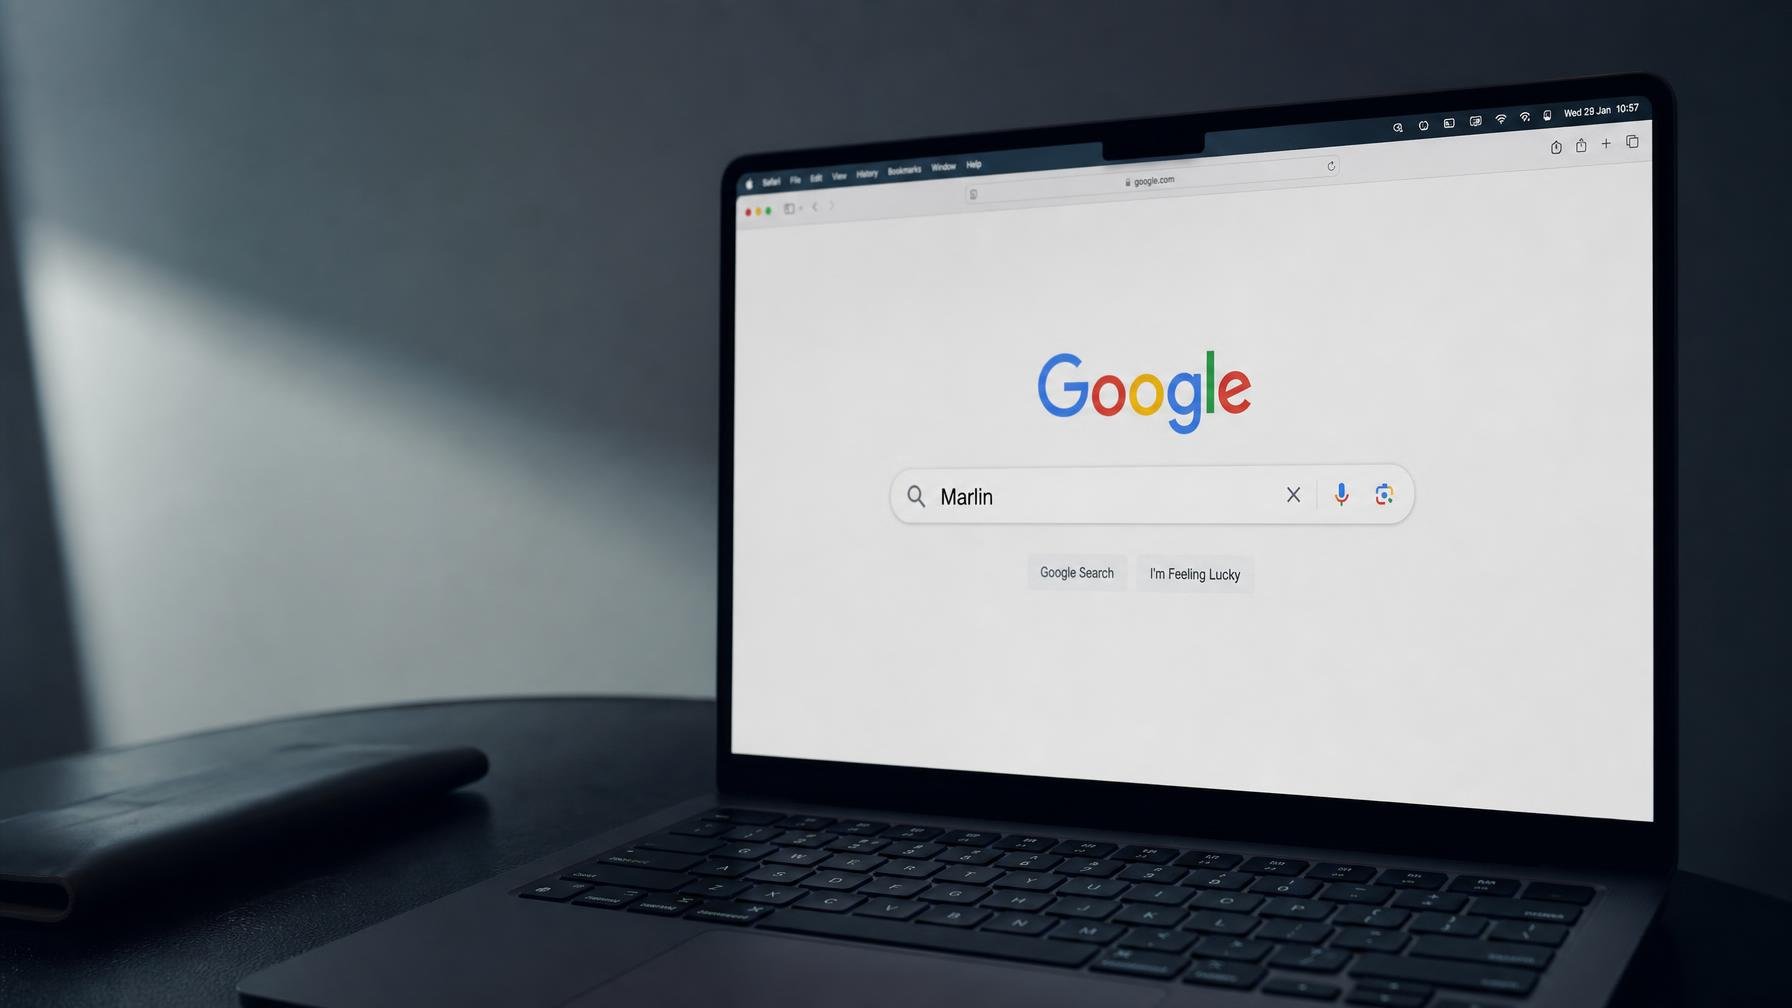
Um gigabyte de disco, cerca de 10$ em GPU na cloud e um fim‑de‑semana livre. Foi o que o programador britânico Alex Morley‑Finch precisou para montar o Marlin, um motor de busca pessoal que ignora o ruído corporativo da web e se concentra em portefólios, zines, projectos de arte esquisitos e software de uma só pessoa. Aquilo que quase nunca sobe ao topo no Google, ocupado com SEO, anúncios e resultados artificiais.
O projecto é aberto e está no GitHub. A arquitectura é propositadamente esquelética: um “fetcher” que recolhe domínios e só olha para homepages, um “worker” que chama um modelo de linguagem compatível com a API da OpenAI para resumir cada página, um “steward” que filtra lixo antes de entrar no índice e uma API com interface web para pesquisar e aplicar filtros. Nada de varrer IPs, nada de Redis, nada de HTML completo guardado, nada de multi‑tenant. É a antítese de um Google Search cheio de camadas, e precisamente por isso é viável para um portátil e uma conta modesta na cloud.
Claro que o plano romântico de “catalogar só o que interessa” chocou com a realidade. A primeira versão, montada em poucas horas, acabou a indexar “a web errada”. Mais de 90 por cento das páginas eram sites corporativos e documentação. Em vez de listas negras de domínios, Morley‑Finch optou por um sistema de pesos de crawl: categorias e tipos de site preferidos sobem na fila, o resto vai para o fundo. A metáfora é simples, mas a implicação é forte, sobretudo num momento em que a própria UE anda a pensar em alternativas à dependência do índice da Google. Se cada pessoa ou comunidade puder definir o que é “prioritário”, o monopólio cultural do algoritmo central começa a fissurar.
O calcanhar de Aquiles do Marlin não foi o custo nem a infraestrutura, foi a classificação. Morley‑Finch deixou o modelo escolher livremente categorias e “tags”, na esperança de que a IA lhe ensinasse uma taxonomia em vez de a impor logo. Resultado: 671 categorias distintas, muitas usadas uma única vez, e mais de 121 mil tags, metade delas também únicas. Uma sopa semântica. Teve de escrever uma ferramenta manual de fusão para limpar aquilo tudo, e concluiu o óbvio que muita gente em IA prefere ignorar: se deixas o modelo “freestyle”, a entropia chega rápido. IA barata indexa, mas não substitui o trabalho de curadoria.
O próprio autor admite que este desenho dificilmente escala para lá de hobby de fim‑de‑semana. Mas é precisamente aí que está a graça. Não é suposto ser a próxima Google, é uma recusa prática da ideia de que pesquisa na web é um serviço único, centralizado e inevitavelmente atrelado a modelos gigantes que canibalizam a própria web que indexam. Há quem prefira desligar as camadas de IA da Google nas ferramentas do dia‑a‑dia, como no nosso guia para tirar o Gemini do Gmail e do Docs. Morley‑Finch foi um passo ao lado: se não gostas da forma como te mostram a internet, constrói tu o teu filtro.
O repositório de Marlin já tem tutoriais e detalhes suficientes para quem quiser replicar a aventura e apontar o crawler para os seus próprios cantos favoritos da rede. Não vai matar o Google, nem precisa. Basta que mais gente olhe para a pesquisa como algo que se pode moldar em casa, em vez de aceitar a versão pré‑embalada que hoje decide o que aparece no teu ecrã.
Fonte: The Register
Os routers gastam pouco, mas morrem ao mesmo tempo que as luzes. Com um pequeno inversor e baterias de ferramentas, podes ter internet durante horas num corte de…
Se apareceu um pequeno auscultador de telefone fixo na barra de estado do teu Android, quase de certeza é o Wi-Fi Calling. Explicamos o que significa, se vale…
O Gmail deixa-te desfazer o envio de emails por até 30 segundos, mas vem limitado a 5 por omissão. Há mais três definições que convém ajustar se passas…
Um jornalista do Android Police contou 50 toques extra em cinco dias só para escolher cartão. Duas definições já presentes no Android da Samsung quase eliminam os pedidos…
Comentários · 0