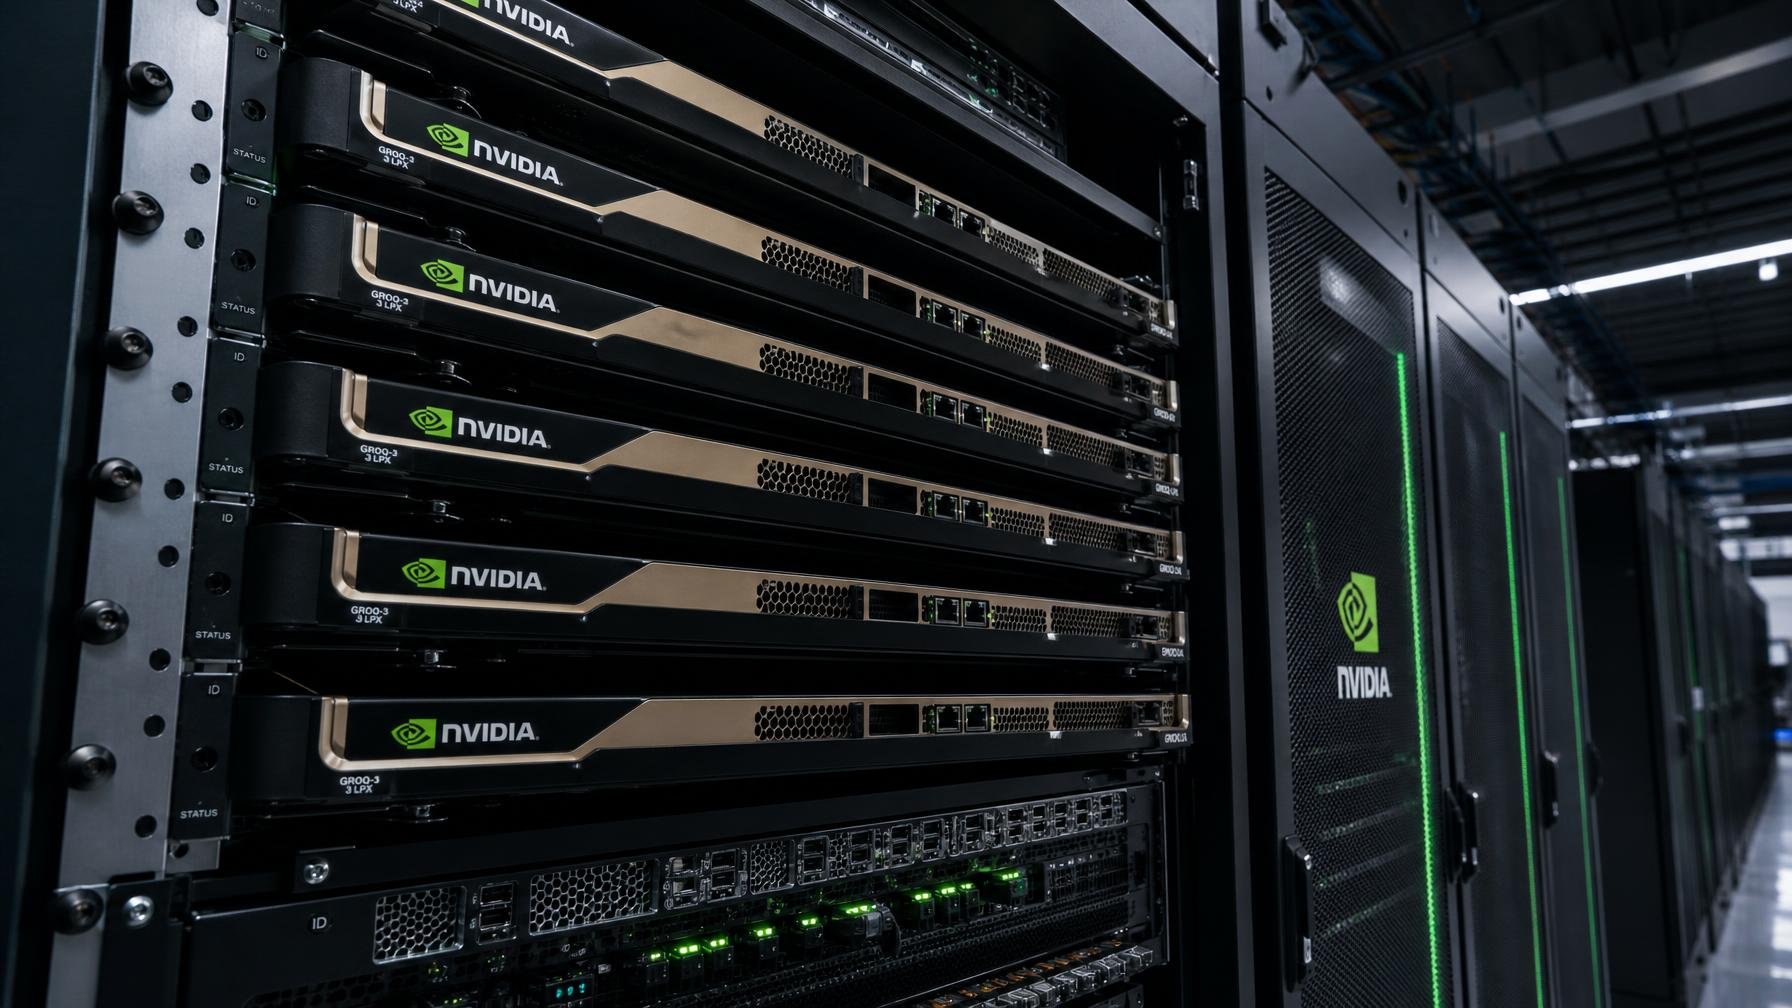
Aposta de 20 mil milhões de dólares, primeiros números públicos: a Nvidia pôs finalmente dados em cima da mesa para as suas LPUs Groq 3, agora integradas nos racks LPX. Num benchmark independente da Artificial Analysis, um destes racks debitou 3.400 tokens por segundo com uma sequência de entrada de 100.000 tokens no Gemma 4 31B da Google. É, grosso modo, quatro vezes mais do que o sistema seguinte no quadro, da Cerebras, que ficou pelos 882 tok/s nas mesmas condições.
O truque não é magia, é arquitetura. As LPUs Groq 3 trocam a DRAM rápida típica das GPUs de datacenter, como GDDR7 ou HBM4, por um mar de SRAM no próprio chip. A latência cai, a largura de banda sobe para valores difíceis de igualar: cerca de 150 TB/s por LPU nesta terceira geração, integrada na plataforma Vera Rubin da Nvidia. Em inferência, onde o gargalo é quase sempre memória, isto é ouro. O preço a pagar é óbvio: a SRAM ocupa área de silício como poucas, o que limita brutalmente a capacidade total.
Vê-se nos números. Enquanto uma GPU Rubin de topo leva 288 GB de memória a bordo, cada LPU Groq 3 traz só 500 MB. Ou seja, 576 vezes menos capacidade local. Para correr um modelo como o Gemma 4 31B é preciso tratar o datacenter como um só chip: o modelo espalha-se por dezenas de LPUs ligadas por Ethernet. Um rack LPX pode ter até 256 LPUs, o que dá 128 GB de SRAM de alta largura de banda. Em teoria, chega e sobra para armazenar várias cópias do modelo em FP8, que anda um pouco acima dos 31 GB de pesos.
A Nvidia não detalha como reparte o modelo, mas tudo aponta para uma mistura clássica de pipeline parallelism com alguma data parallelism. Em termos simples: diferentes partes do modelo vivem em diferentes chips, as requisições fluem em pipeline e, como há SRAM suficiente, é possível duplicar esse pipeline várias vezes para servir mais pedidos em paralelo. O Gemma 4 31B é, no entanto, um alvo quase perfeito para este tipo de arquitetura. Cabe num único rack, os caminhos de comunicação mantêm-se curtos e a coisa brilha no benchmark.
Problema: o mundo da IA de 2026 não vive de modelos de 31 mil milhões de parâmetros. Vive de Mixture-of-Experts (MoE) gigantes, modelos multimodais com centenas de milhares de milhões de parâmetros lógicos e padrões de acesso à memória bem mais caóticos. É aí que a aposta Groq 3 vai ser testada a sério. Ligar racks LPX em cadeia e manter latências baixas, com Ethernet no meio e modelos moreirados em milhares de shards, é outra conversa. Por enquanto, temos só o cenário ideal, num modelo que, para padrões atuais, cabe numa RTX 4090 bem alimentada em casa.
Apesar disso, o sinal de mercado é claro. A Nvidia está a tratar a inferência de baixa latência para agentes de IA como produto premium, não acessório. Se um agente de código ou de automação puder raciocinar mais passos no mesmo tempo, a Nvidia acredita que as grandes empresas vão pagar esse extra. É o mesmo raciocínio que já vimos na subida de preços dos servidores de IA Nvidia, empurrada pela escassez de memória. Agora reforçado pela compra da Groq e pela entrada de clouds europeias como a Nebius, nos Países Baixos, como primeiros clientes destes racks LPX. Para quem gere datacenters na Europa, a pergunta não é se o hardware é rápido. É se a factura energética, de rede e, claro, de licenciamento Nvidia, aguenta o entusiasmo.
Fonte: The Register




Comentários · 0