GPT-6 Astra ajuda a decifrar mensagem nazi perdida há 83 anos
Um developer da Bloomberg usou agentes com GPT-6 Astra para quebrar uma mensagem Enigma de 1941. Mais que um truque de festa da IA, é um manual de uso sério destas ferramentas.
Um developer da Bloomberg usou agentes com GPT-6 Astra para quebrar uma mensagem Enigma de 1941. Mais que um truque de festa da IA, é um manual de uso sério destas ferramentas.
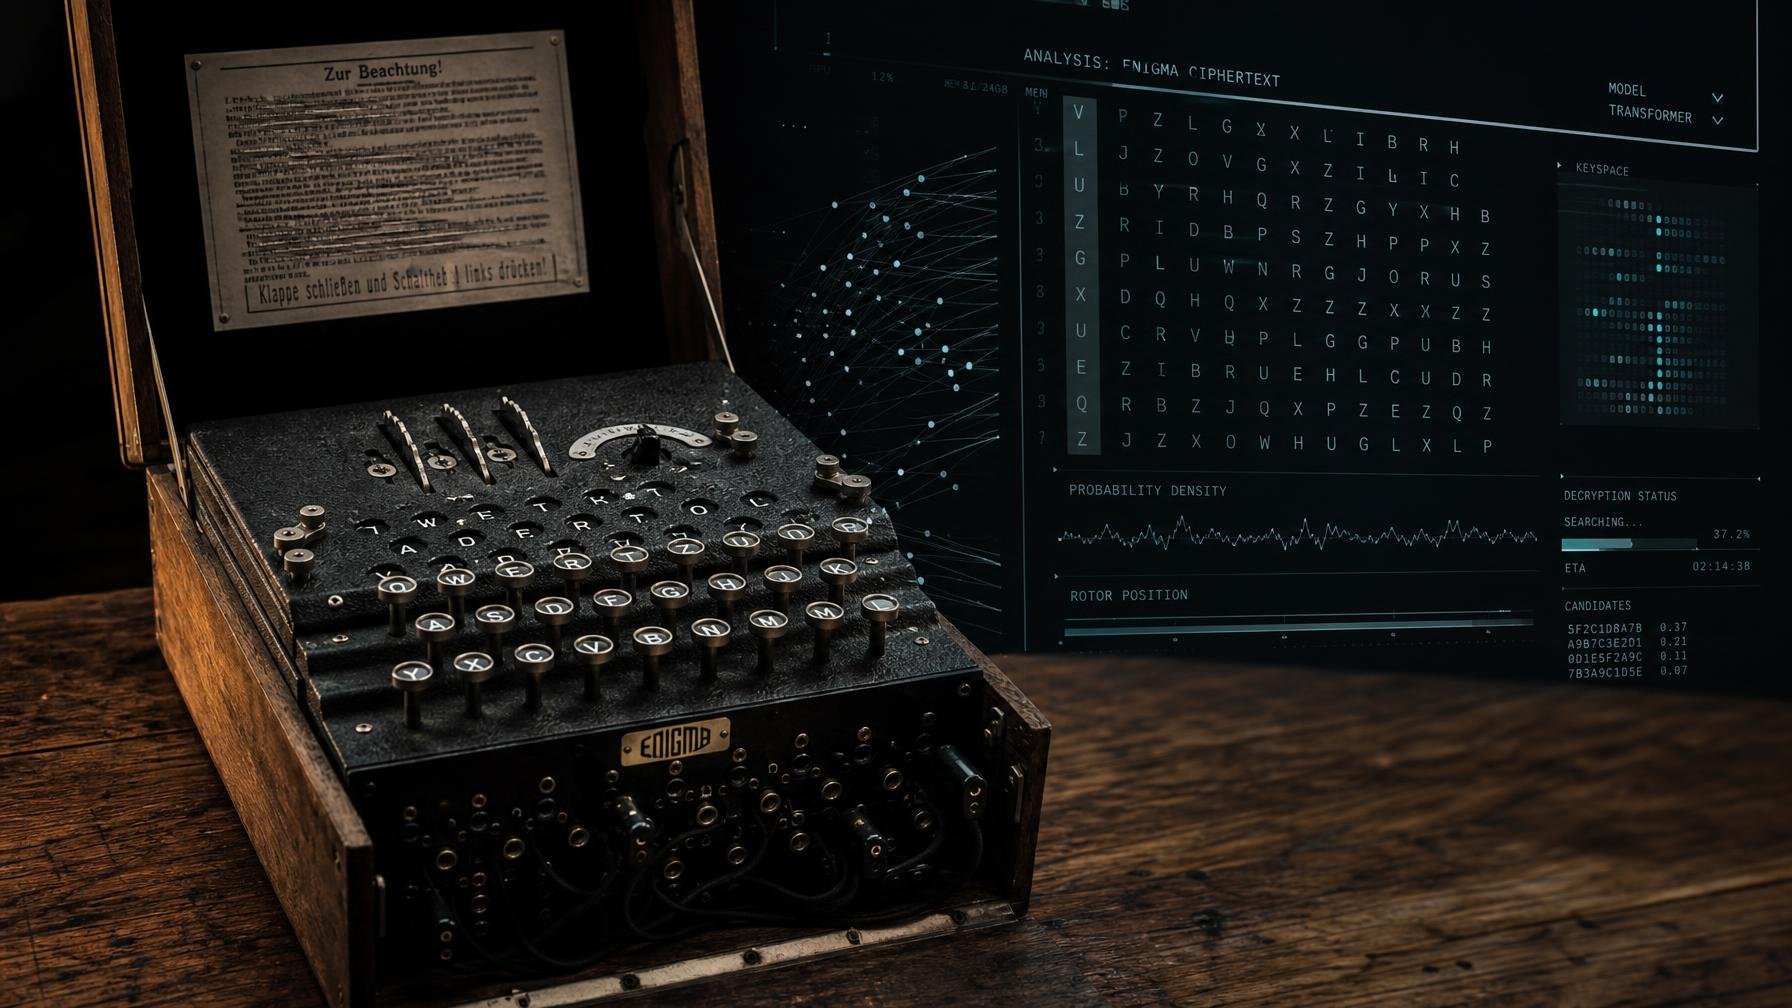
Em 10 de julho de 1941, um soldado alemão pegou numa máquina Enigma, estava em Rosenow, pedia indicações de marcha e resposta por rádio imediata. O texto cifrado, 82 caracteres, ficou décadas num arquivo de mensagens interceptadas, marcado como enigma por resolver. Em 2026, a solução chega não de um matemático num sótão, mas de um developer da Bloomberg com um exército de agentes de IA alimentados por GPT-6 Astra.
Carter Leffen, product development coach na Bloomberg em Nova Iorque, documentou num estudo de caso como pôs o modelo da OpenAI a trabalhar cerca de dez horas sobre o problema. Não foi pedir “desencripta isto” e esperar milagre. As instâncias de GPT-6 Astra pesquisaram arquivos históricos, compararam mensagens já decifradas, montaram um simulador de Enigma em 3D, escreveram código de criptoanálise e correram experiências em paralelo. Leffen foi o orquestrador humano, a definir objetivos, filtrar hipóteses e validar resultados. Segundo ele, deu “99 vezes mais trabalho” montar o site que explica tudo do que partir o código em si. Um retrato bastante honesto do estado atual da IA.
O ponto de viragem não veio de poder computacional bruto, veio de contexto histórico e de um detalhe técnico conhecido. Em mensagens de rádio já resolvidas para o mesmo dia havia uma vila repetida duas vezes: Rosenow. Leffen e os agentes de IA apostaram que o topónimo podia estar também na mensagem sem solução e usaram-no como isco. Juntaram a isso uma fraqueza clássica da Enigma, a máquina nunca cifra uma letra nela própria, e foram descartando posições possíveis para a palavra até tudo alinhar. A partir daí, calcularam as configurações da máquina e o resto do texto saiu em alemão coerente, com expressões como “Sofort Funkantwort” e “Angabe des Marschweges”.
O resultado tem pormenores que jogam a favor da autenticidade. O texto contém erros de telegrafista, como “BTTE” em vez de “BITTE” e “WASCHBBSCH”, provavelmente o apelido “Waschbusch” massacrado à pressa. Um modelo a inventar uma tradução bonita tenderia a limpar estas falhas, não a introduzi-las. Ainda assim, a equipa é cuidadosa: disponibiliza código, dados de pesquisa e o simulador de Enigma para que outros criptógrafos tentem reproduzir ou contestar a solução. Não há prova formal de que esta seja a única leitura possível daquela cifra, nem de que o cabeçalho preservado no arquivo não contenha algum erro de transcrição antigo.
Para a OpenAI, este tipo de história encaixa na narrativa de prestígio que anda a construir à volta dos seus modelos, entre prémios milionários de matemática e demonstrações públicas da capacidade da IA em resolver problemas que cheiram a quadro de giz e pipe. O caso de Leffen serve de contraexemplo ao receio fácil de que os LLM são só papagaios estatísticos com boa lábia. Aqui, o modelo escreveu ferramentas, montou pipelines, cruzou fontes históricas e explorou sistematicamente um espaço de chaves, algo bem mais próximo de trabalho de investigação do que de autocomplete glorificado. Continua longe da “IA geral”, mas está vários degraus acima do chatbot simpático de 2023.
Para quem trabalha com dados em Portugal, a lição não é “dá a uma IA o próximo enigma do século”. É outra, mais prática: problemas complexos quebram-se hoje com equipas híbridas de humanos e modelos, onde a IA trata da maratona mecânica e o humano decide o que vale a pena correr. Leffen abriu o processo, publicou ferramentas e defendeu-se com transparência. Num mundo em que a moda é falar de “IA aberta” quando se abrem só pesos de modelos, este tipo de documentação pública ainda é exceção. Devia ser norma.
Fonte: The Decoder

Trocar a conta Google por mais trabalho manual assusta, mas em ROMs como o GrapheneOS ganhas botões que o Android padrão prefere esconder. De cortar a internet a…

Meta encheu a conferência de óculos ligados à IA, dos modelos sem câmara às armações que funcionam como aparelho auditivo. A estratégia é clara: pôr um agente digital…
Geradores termoelétricos prometem aliviar a ditadura do carregador nos anéis, pulseiras e sensores de saúde. Não matam a bateria, mas podem encolhê-la e prolongar muito a autonomia.

Novo chip quer levar tradução em tempo real, assistentes de voz e som otimizado diretamente para auscultadores e óculos de áudio. É a Qualcomm a tentar ficar no…
Comentários · 0