Google Deepmind quer fazer visão computacional só com modelos de vídeo
GenCeption usa um gerador de vídeo pré-treinado como modelo do mundo e disputa o lugar de sistemas especializados de profundidade, segmentação e pose 3D, com muito menos dados.
GenCeption usa um gerador de vídeo pré-treinado como modelo do mundo e disputa o lugar de sistemas especializados de profundidade, segmentação e pose 3D, com muito menos dados.
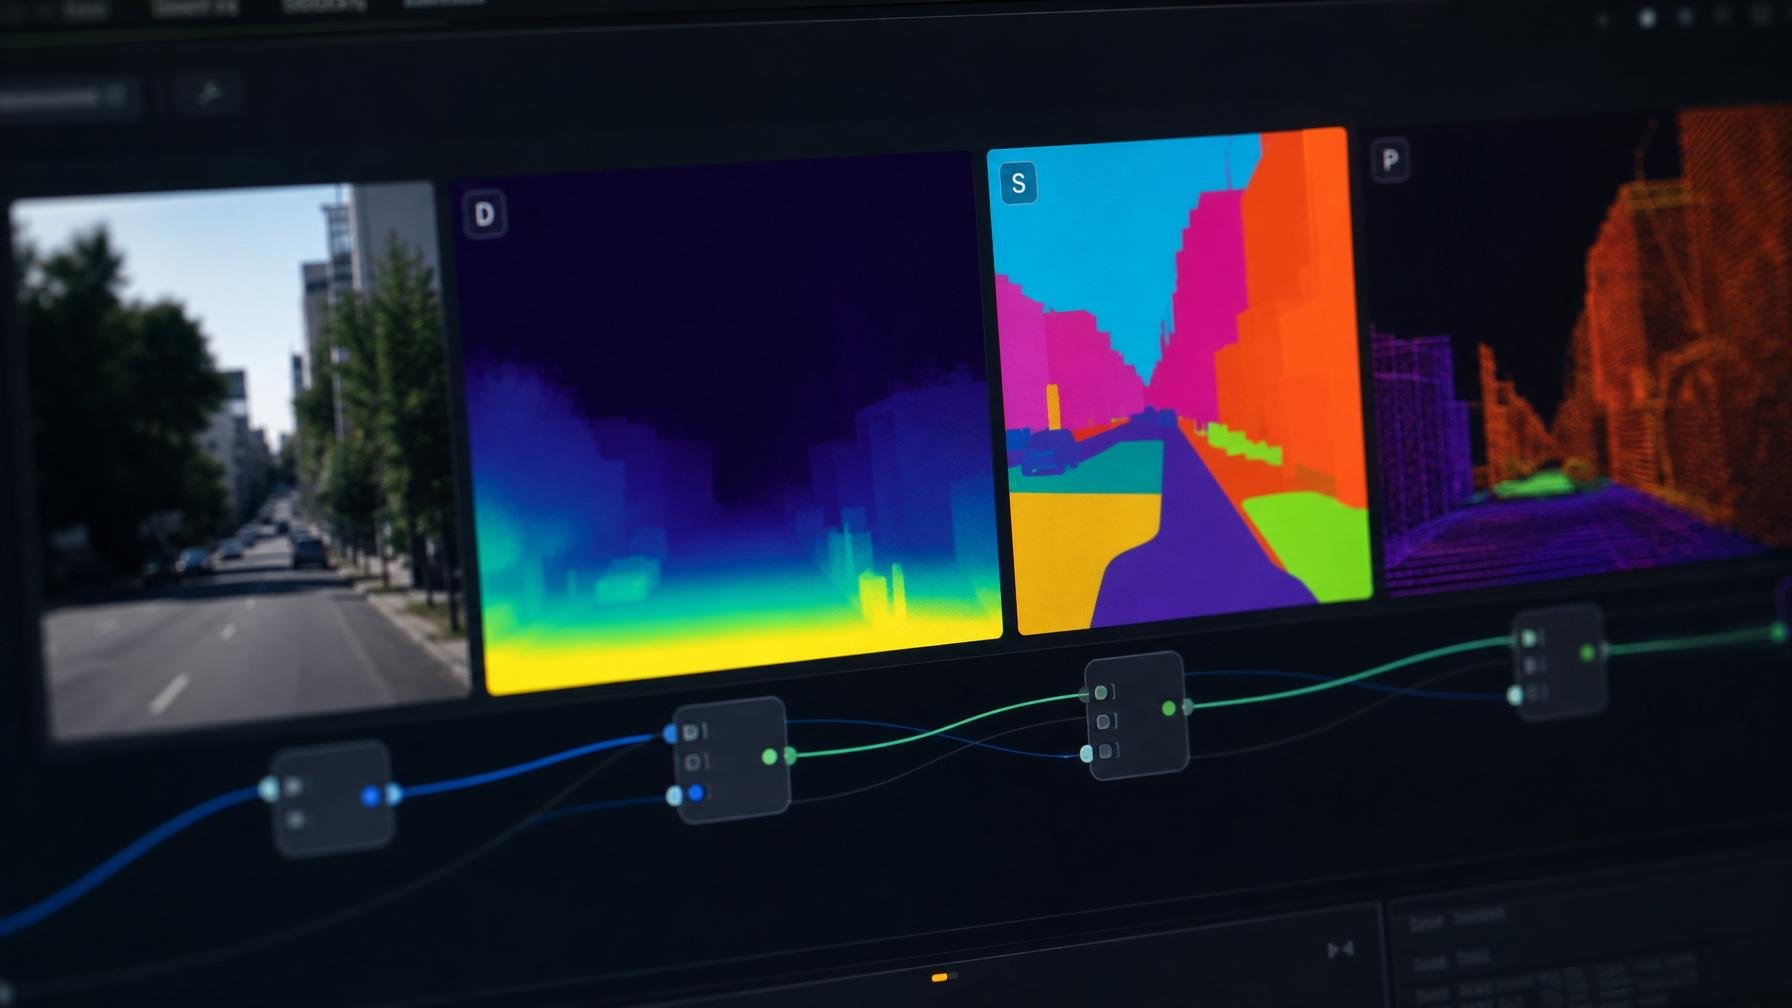
Os investigadores da Google Deepmind voltam a bater na mesma tecla: os grandes modelos de vídeo não são só brinquedos para gerar clips surreais, podem ser o tal “modelo do mundo” que a visão computacional anda a prometer há anos. O exemplo concreto chama-se GenCeption e parte de um gerador de vídeo open source da Alibaba para resolver tarefas clássicas de visão com uma só passagem de inferência.
A comparação com linguagem é óbvia e a própria Deepmind faz o paralelo. Os modelos de texto aprenderam gramática, contexto e muito do “senso comum” só a prever a próxima palavra. Em visão, continuamos presos a modelos hiper-especializados: um para segmentação, outro para profundidade, outro para pose 3D, todos com arquitecturas próprias. É eficiente em benchmarks, é um pesadelo em manutenção e integração no mundo real.
O argumento de Deepmind é simples: se um modelo de texto-para-vídeo consegue gerar cenas coerentes, com geometrias plausíveis, movimentos físicos aceitáveis e alinhadas com descrições em linguagem natural, então já codifica internamente muito da estrutura do mundo. Em vez de inventar uma nova arquitectura de raiz para cada tarefa de visão, GenCeption reaproveita o corpo desse gerador de vídeo, afinando-o para cuspir mapas de profundidade, normais de superfície, máscaras de segmentação ou estimativas de pose a partir de um vídeo real.
O truque técnico é quase minimalista. GenCeption converte todas as saídas possíveis em imagens RGB de três canais, mesmo quando o que se quer é um mapa de profundidade ou as trajectórias da câmara. Uma prompt de texto indica qual a tarefa a executar, como se fosse uma instrução num chatbot. Para coisas que não são naturalmente “imagens”, como keypoints 3D esparsos, os autores colam módulos treináveis específicos em cima do modelo principal. Tudo isto funciona numa única forward pass, em vez das dezenas ou centenas de passos típicos de um modelo de difusão. Tradução: velocidade suficiente para aplicações práticas e não só para papers.
Mais picante é o lado dos dados. Em vez de devorar milhões de vídeos anotados, GenCeption treinou sobretudo em conteúdo sintético: cerca de 7.500 vídeos gerados com 800 modelos humanos digitais combinados com 200 sequências de movimento captadas em estúdio e renderizadas em Blender. Com esta dieta relativamente modesta, o sistema consegue igualar modelos especializados em benchmarks de profundidade, segmentação e pose, e ainda generalizar para vídeo real e para categorias que nunca viu, como animais. Isto vai ao encontro da narrativa de que etiquetar menos dados, mas mais estruturados, pode ser mais importante do que escalar tudo à força bruta, uma discussão que pesa tanto na factura energética dos grandes modelos como se viu no caso da IA a inflacionar emissões da Microsoft.
Há, claro, um grau saudável de cepticismo a manter. “Modelo do mundo” é expressão que a investigação em IA adora e raramente define. GenCeption ainda vive num laboratório, encostado a benchmarks controlados e a cenas sintéticas relativamente limpas. Entre isto e meter um único modelo a perceber, em tempo real, vídeo ruidoso de uma câmara de bordo num autocarro em hora de ponta vai um salto grande. Mas a direcção é clara: se os grandes modelos de visão forem mesmo o GPT-1 desta área, quem está hoje a investir só em “Modelos Anything” ultra-especializados pode descobrir que andou a optimizar a peça errada do puzzle.
Fonte: The Decoder

Os primeiros Nest Learning Thermostat perderam funções ligadas à cloud em 2025 e ficaram reduzidos ao básico. Um projeto open source devolve-lhes agendamento remoto, integrações e um pouco…

A fuga não é só por causa da IA do Copilot. Há uma lista crescente de queixas e alternativas maduras para onde comunidades inteiras estão a migrar.

Mapas de divisão, câmaras, microfones e cloud transformaram os aspiradores‑robô em sensores ambulantes. O problema não é só técnico, é de modelo de negócio e de políticas de…

Os novos óculos inteligentes da HTC fazem quase o mesmo que os de Meta, mas trocam a sede de dados por limites claros: IA sem login, vídeos cifrados…
Comentários · 0