Esta startup israelita quer matar a GPU com 128TB de memória barata
A Majestic Labs apresentou o Prometheus, um servidor Arm com LPDDR6 a granel que promete envergonhar racks Nvidia em memória e energia. Por enquanto, tudo vive em slides.
A Majestic Labs apresentou o Prometheus, um servidor Arm com LPDDR6 a granel que promete envergonhar racks Nvidia em memória e energia. Por enquanto, tudo vive em slides.
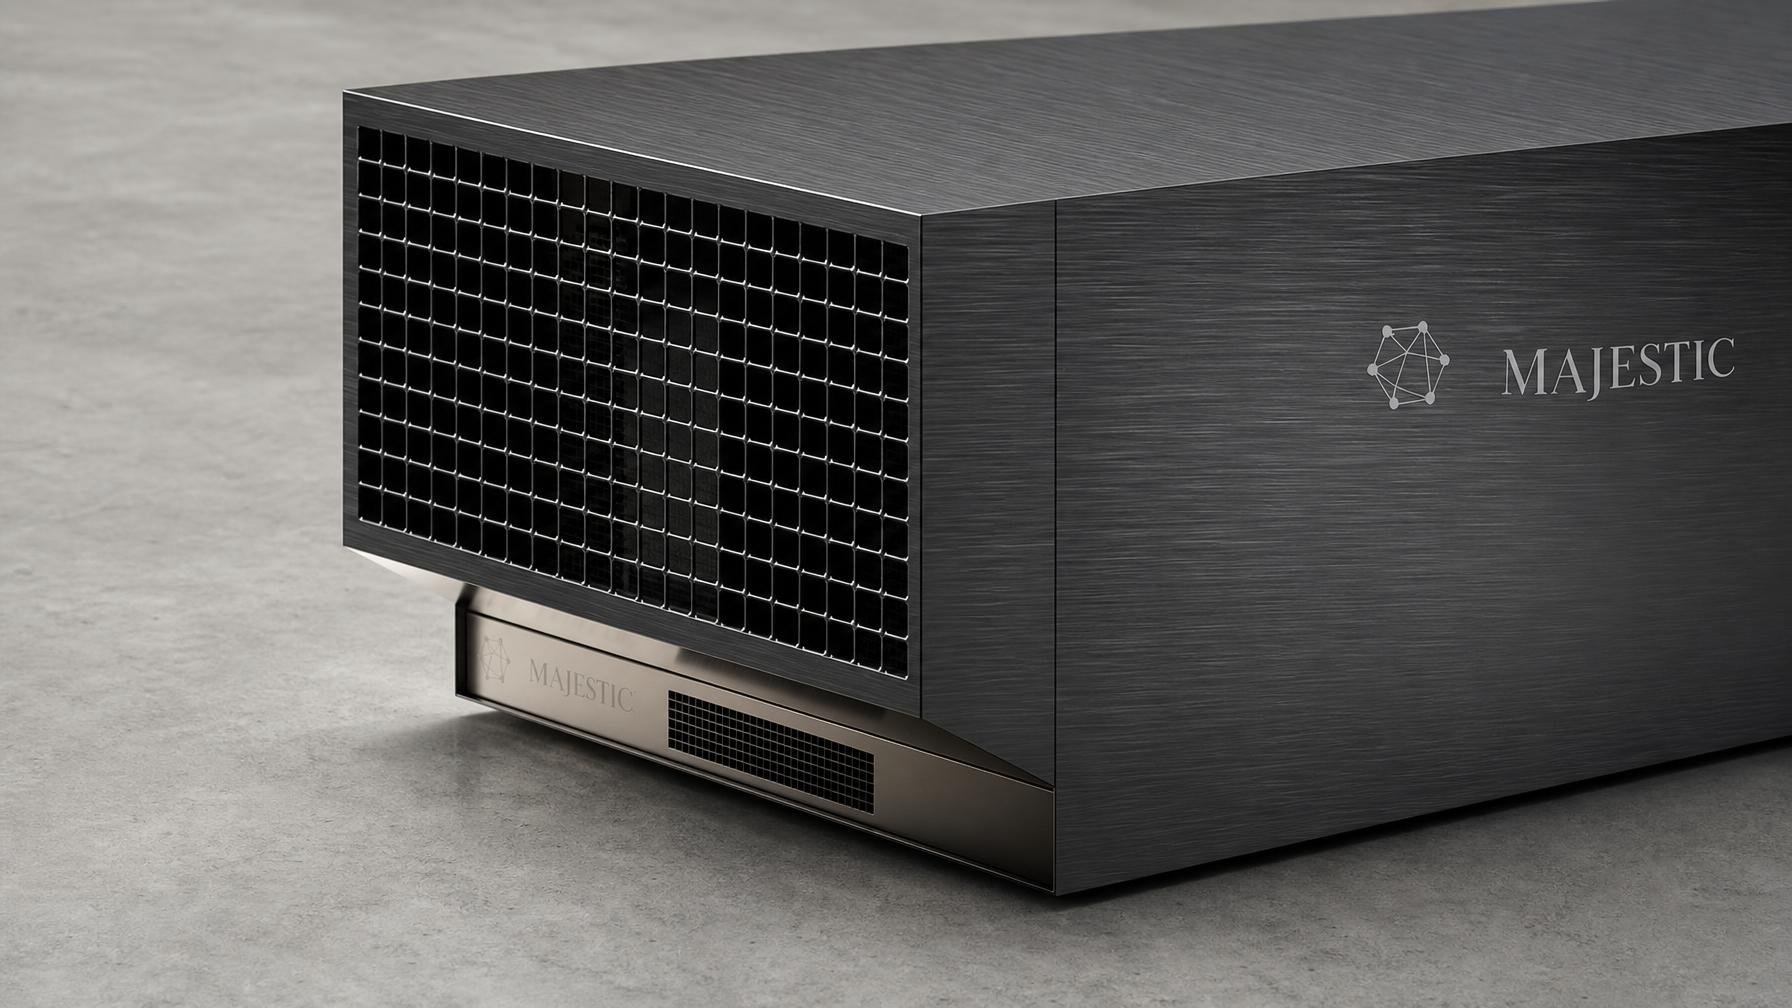
Enquanto toda a gente fala de TFLOPS e GPUs, a Majestic Labs entra na sala a apontar para outro lado: memória. A startup de Tel Aviv, fundada em 2023 por antigos engenheiros da Google e da Meta, apareceu com um servidor de IA chamado Prometheus que abdica por completo da GPU e aposta tudo em LPDDR6, a mesma memória barata que encontras no telemóvel.
A tese é simples e não é absurda. Hoje, grande parte da inferência de modelos grandes não esbarra no limite de cálculo, esbarra na quantidade de memória rápida que consegues endereçar. GPUs topo de gama coladas a HBM (High Bandwidth Memory) tornaram-se blocos caríssimos, escassos e com pouca flexibilidade. A Majestic diz que esta arquitetura é um beco sem saída, o chamado “memory wall” que já está a bater à porta dos gigantes, como se viu quando a Apple começou a amontoar inventário de memória para não ficar refém da escassez.
O Prometheus troca GPUs por unidades próprias, as Ignite AI Processing Units. Cada uma combina núcleos Arm com motores vectoriais e tensoriais em RISC-V. Até 12 destas unidades partilham um único pool entre 8TB e 128TB de LPDDR6. Em vez de colar memória a cada chip, a Majestic usa chiplets de agregação feitos à medida e liga tudo com cabos de cobre até 1 metro, criando o que descreve como um único espaço de memória coerente, muito maior do que qualquer caixa de GPUs consegue expor.
É nos números que a startup carrega no marketing. Um servidor Nvidia DGX B300 com oito GPUs Blackwell traz 2,3TB de HBM. A Majestic diz que o Prometheus oferece mais de 50 vezes essa memória “rápida” e 1,7 vezes a largura de banda de interligação. Um único rack, afirma, iguala 25 racks Vera Rubin da Nvidia em memória rápida, consumindo muito menos energia. Se metade disto for verdade, os custos de alojar modelos gigantes para inferência ficariam virados ao contrário. A narrativa encaixa bem num ano em que já vimos a pressão na cadeia de fornecimento de memória empurrar produtos como o Mac Mini para prazos ridículos.
Do lado do software, a Majestic tenta tirar ansiedade aos clientes: suporte declarado para PyTorch, vLLM e Triton da OpenAI, adesão a standards abertos e promessa de correr modelos feitos para GPU sem alterações. Na teoria, encaixar o Prometheus num stack actual seria mais um trabalho de DevOps do que de investigação. A empresa diz já ter encomendas de grandes empresas, neoclouds e hyperscalers. O detalhe que falta: ainda não enviou uma única unidade.
É aqui que a conversa volta à terra. Todos os números vêm da própria Majestic, não há benchmarks independentes, não há hardware em produção. A escala física também levanta sobrancelhas: para chegar aos 128TB com dies de 2GB de LPDDR6 seriam precisos cerca de 64.000 chips, distribuídos por mais de uma centena de chiplets de agregação num só servidor. Manter isso tudo coerente, frio e fiável não é uma folha de cálculo, é engenharia de guerra. A Majestic junta-se assim a uma fila de startups que atacam a Nvidia por ângulos laterais, dos chips ópticos aos aceleradores de edge. Algumas vão ficar pelo caminho, outras podem forçar a indústria a admitir o óbvio: sem resolver a memória, a corrida da IA acaba num muro.
Fonte: The Next Web

Os primeiros Nest Learning Thermostat perderam funções ligadas à cloud em 2025 e ficaram reduzidos ao básico. Um projeto open source devolve-lhes agendamento remoto, integrações e um pouco…

A fuga não é só por causa da IA do Copilot. Há uma lista crescente de queixas e alternativas maduras para onde comunidades inteiras estão a migrar.

Mapas de divisão, câmaras, microfones e cloud transformaram os aspiradores‑robô em sensores ambulantes. O problema não é só técnico, é de modelo de negócio e de políticas de…

Os novos óculos inteligentes da HTC fazem quase o mesmo que os de Meta, mas trocam a sede de dados por limites claros: IA sem login, vídeos cifrados…
Comentários · 0