Claude Fable 5.1 desce preços e sobe nos benchmarks de código
A Anthropic afina a linha Claude com o novo Fable 5.1: melhor em código e tarefas "agentic", mas a matemática dos custos é menos simples do que o marketing sugere.
A Anthropic afina a linha Claude com o novo Fable 5.1: melhor em código e tarefas "agentic", mas a matemática dos custos é menos simples do que o marketing sugere.
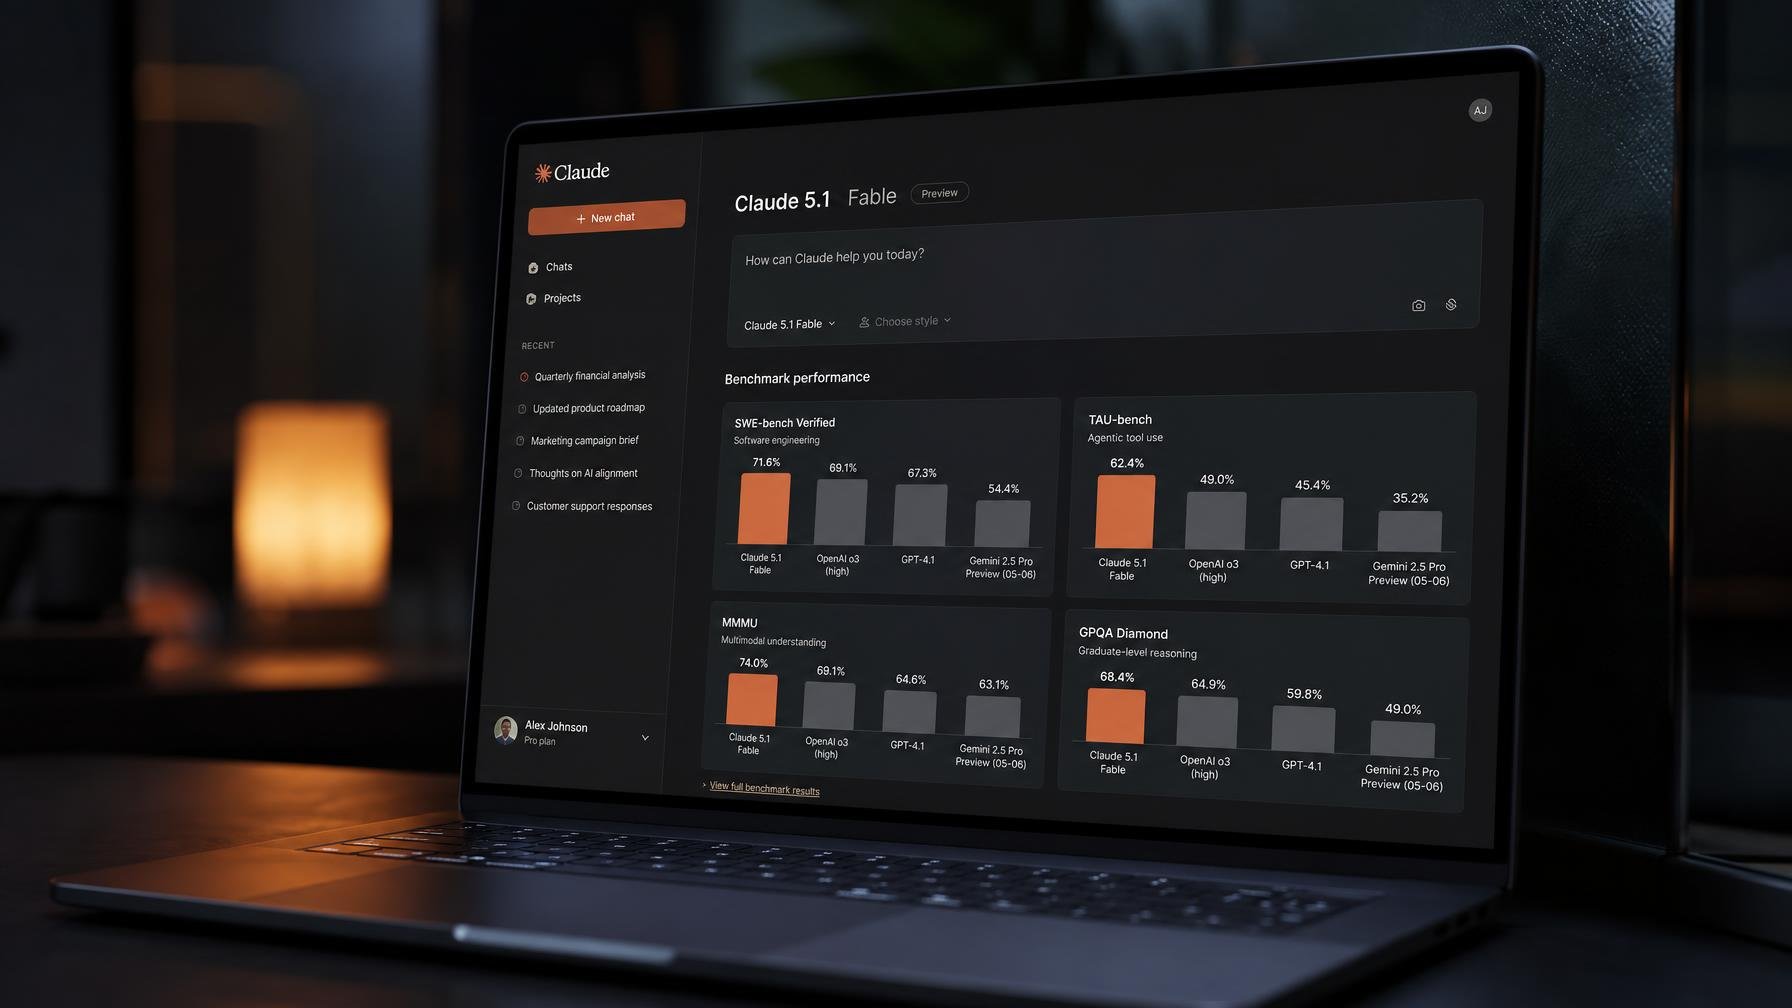
A Anthropic voltou a mexer na linha Claude. Fable 5.1 e Mythos 5.1 chegam como os modelos mais fortes da casa, com ganhos claros em benchmarks de código e pesquisa automática, e uma narrativa agressiva de poupança de custos até 45 por cento. Só que os números, vistos com lupa, contam uma história menos simpática para quem paga a conta.
Tal como nas versões anteriores, Fable 5.1 e Mythos 5.1 partilham o mesmo modelo base, mas com guardrails diferentes. Fable é o generalista, disponível a qualquer cliente da API. Mythos fica fechado a programas especiais em cibersegurança e ciências da vida, onde o apetite por respostas arriscadas é maior. A novidade estrutural é outra: estes são os primeiros Claude com marcas de água embutidas em todo o texto gerado.
A Anthropic lançou também uma detecção em API, em pré-visualização privada, que permite a reguladores, media e instituições de investigação verificarem se um texto traz esse watermark. Em teoria, isto dá uma ferramenta para separar texto humano de texto gerado, algo que interessa tanto a quem combate desinformação como a quem está a montar pipelines de IA em produção. Na prática, põe a Anthropic a decidir quem tem o verificador, o que é um detalhe de poder que costuma passar despercebido.
No preço, o argumento de venda é simples: Fable 5.1 seria cerca de 25 por cento mais barato que Fable 5 em cargas típicas, e até 45 por cento menos em workflows muito “agentic” com sessões longas e muitas chamadas de ferramentas. O truque está na cache, que desce de 1$ para 0,25$ por milhão de tokens reutilizados. O resto da tabela fica igual, 10$ por milhão de tokens de input e 50$ por milhão de output, contra os 5$/25$ de Opus 5. Traduzindo: o modelo continua premium e exige confiar bastante nas poupanças por cache.
É aqui que entra a Artificial Analysis, empresa que ajudou nos testes pré-lançamento e agora contraria a narrativa oficial. Segundo os dados que publicou, em cenários de “max effort” o Fable 5.1 gera cerca de 1,7 vezes mais tokens de saída. Resultado: por tarefa no benchmark Intelligence Index, Fable 5.1 chega a 3,76$ onde Fable 5 custava menos, e continua mais caro que Opus 5, que fica em 2,34$ com apenas três pontos de diferença na pontuação. Ou seja, em carga máxima, o suposto modelo mais eficiente pode sair 20 por cento mais caro por tarefa.
Nos benchmarks, porém, há saltos difíceis de ignorar. No Terminal-Bench-Science 0.1, focado em investigação científica automatizada, Fable 5.1 passa de 24,7 para 52,6 por cento, mais do dobro da geração anterior e bem acima de GPT-5.6 Sol. Em Terminal-Bench 4.0 para programação “agentic”, Fable 5.1 atinge 55,8 por cento e Mythos 5.1 sobe a 60,9 por cento, contra 42 por cento de Fable 5. Também em tarefas de automação de workflows de negócio (AutomationBench) e de uso de computador (OSWorld 2.0) se vê um padrão: melhorias consistentes, mas muitas vezes com Opus 5 ali ao lado, a pontuar quase igual com preços mais baixos.
Há ainda o lado menos medido dos benchmarks: o estilo. Um investigador da Anthropic admite que os Claude anteriores abusavam de listas, negritos e formato “apresentação PowerPoint” em chat. Fable 5.1 tenta soar mais natural e seguir melhor instruções de estilo, algo que importa a quem o quer pôr a escrever relatórios ou a resumir documentos internos. Para empresas em Portugal, o dilema continua o mesmo que já se sente noutros contextos de IA generativa e que temos visto também em áreas como a saúde: aceitar pagar por modelos de topo, ou apostar em algo “quase tão bom” mas financeiramente mais razoável. O hype da frontier AI vai tendo de caber nos orçamentos reais.
Fonte: The Decoder

Os primeiros Nest Learning Thermostat perderam funções ligadas à cloud em 2025 e ficaram reduzidos ao básico. Um projeto open source devolve-lhes agendamento remoto, integrações e um pouco…

A fuga não é só por causa da IA do Copilot. Há uma lista crescente de queixas e alternativas maduras para onde comunidades inteiras estão a migrar.

Mapas de divisão, câmaras, microfones e cloud transformaram os aspiradores‑robô em sensores ambulantes. O problema não é só técnico, é de modelo de negócio e de políticas de…

Os novos óculos inteligentes da HTC fazem quase o mesmo que os de Meta, mas trocam a sede de dados por limites claros: IA sem login, vídeos cifrados…
Comentários · 0