eBPF no Linux: plugins de kernel para segurança sem dramas
eBPF deixa-te “programar” o kernel com travões de segurança que faltam aos módulos clássicos. Vale tanto para observabilidade em produção como para apertar a rede contra ataques.
eBPF deixa-te “programar” o kernel com travões de segurança que faltam aos módulos clássicos. Vale tanto para observabilidade em produção como para apertar a rede contra ataques.
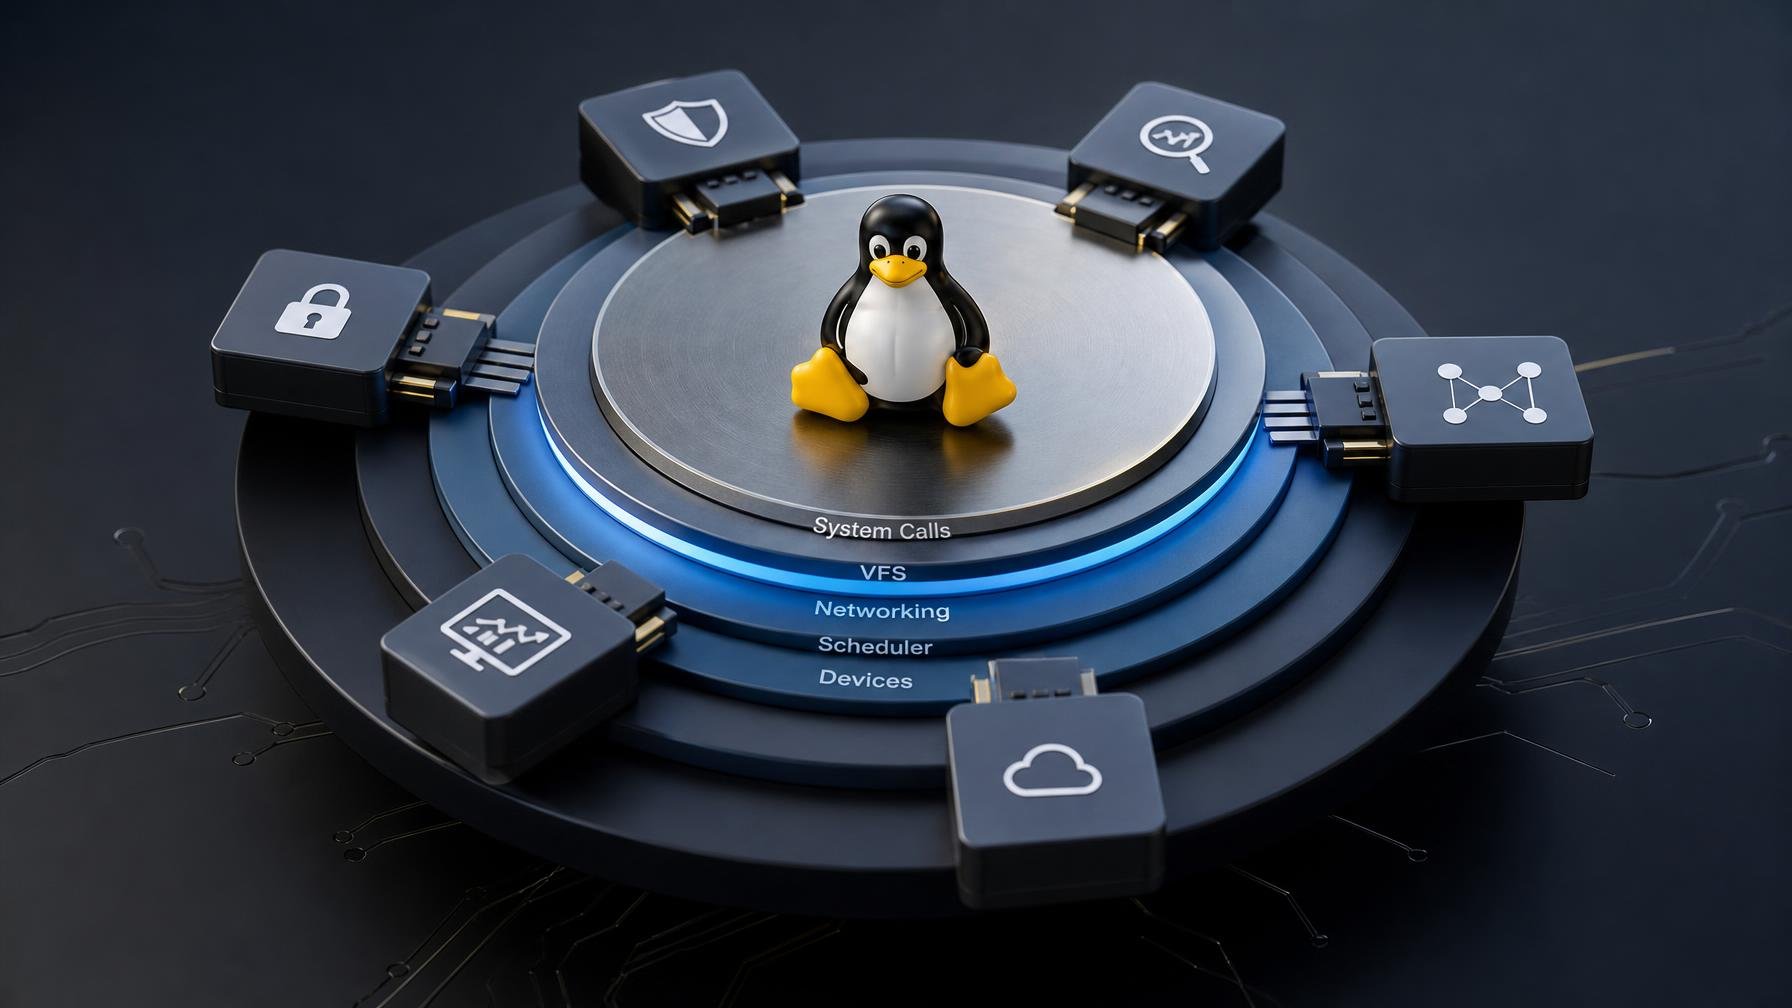
eBPF tem tudo o que costuma afastar programadores: kernel, bytecode, verificadores formais. Mesmo assim, virou estrela. Há fundação, workshop na ACM SIGCOMM e até documentário. Não é hype vazio, é poder correr pequenos programas em espaço de kernel sem o terror clássico de rebentar a máquina em produção.
O rótulo de “JavaScript para o kernel” é meio preguiçoso, mas acerta num ponto: plugins dinâmicos. Escreves código que o kernel carrega, liga a pontos críticos do sistema e consegue observar ou intervir em tempo real. Tráfego de rede, chamadas de sistema, agendamento de processos, tudo passa a ser gancho potencial. Coisas que em espaço de utilizador são lentas ou impossíveis, aqui acontecem antes de o pacote entrar sequer na stack de rede ou de o processo ganhar tempo de CPU.
Comparado com módulos de kernel, eBPF é aparentemente mais fraco. Um módulo é, na prática, um pedaço de kernel com poderes totais. O detalhe é esse: totais. Um bug e o servidor vai abaixo. eBPF vive cheio de restrições impostas pelo próprio kernel, com um verificador que recusa programas que possam causar loops infinitos, acessos fora de memória permitida ou chamadas não autorizadas. À superfície é frustrante, na prática é isto que torna extensões de kernel menos suicidas e aceitáveis para equipas de operações que vivem em modo 24/7.
Daí a adoção agressiva por Google, Meta, Cloudflare, Netflix e companhia. A tecnologia saiu do Linux genérico para hardware especializado, como SmartNICs que carregam programas eBPF para filtrar tráfego na placa de rede, e está a caminho do Windows, com a Microsoft a trabalhar suporte nativo. Em Portugal, isto interessa a quem gere clusters Kubernetes, plataformas de streaming ou infra multifornecedor: é a diferença entre despejar iptables em todo o lado ou ter uma camada programável e observável de raiz.
Os exemplos mais óbvios aparecem na rede. Cilium usa eBPF para ser a interface de rede de alto desempenho em Kubernetes, atirando o velho kube-proxy e as cadeias iptables para segundo plano. Mais perto do dia-a-dia, projetos como bpfilter convertem regras de filtragem em programas eBPF e fazem o trabalho sujo de os carregar e ligar às interfaces. Com a ferramenta de linha de comandos bfcli consegues, por exemplo, definir uma cadeia ligada a XDP (eXpress Data Path) que deita ao lixo todos os pacotes ICMP logo no driver da placa. O ping do vizinho nunca chega a entrar na stack IP, e a CPU agradece.
XDP é o sítio onde se vê bem a vantagem: filtrar na placa, antes de o kernel perder tempo com um ataque de negação de serviço, não é um luxo, é sobrevivência para quem vive exposto na Internet. Não é surpresa que mitigação de DDoS moderna se agarre a isto. Mais interessante ainda é que ferramentas como bpfilter ou xdp-filter escondem quase toda a complexidade de eBPF, por isso não precisas de escrever C para tirar partido da tecnologia.
Há um custo: debugging de eBPF continua menos simpático que seguir logs de um serviço em user space, e o verificador do kernel às vezes parece um revisor de código paranóico. Mas a alternativa continua a ser escrever módulos de kernel à mão ou resignar-te a caixas negras de fabricantes de appliances. Para quem quer visibilidade profunda e controlos precisos sem trocar a estabilidade do servidor por um tiro no escuro, eBPF deixou de ser curiosidade académica. É ferramenta de trabalho.
Fonte: Open Source For You
Não é preciso um comando desastroso para rebentar uma instalação Linux. Pequenas rotinas erradas, repetidas durante meses, chegam para transformar um sistema estável num campo minado.
Primeira atualização de manutenção do Plasma 6.8 arruma falhas chatas no gestor de tarefas, acessibilidade, RDP e ferramentas como Spectacle e Klipper. Quem vive em KDE quer isto…
A distribuição minimalista baseada em Gentoo chega à versão 26.10 com kernels recentes, builds otimizados x86-64-v3 e novas edições COSMIC e KDE mais polidas.
Bug PwnEscape, já com CVE atribuído e severidade 9,3, mostra que a virtualização Linux não é muralha inquebrável. Nuvens públicas e privadas têm correções a aplicar, rápido.
Comentários · 0