Falha no GitHub trava repositórios, Actions e API em pleno dia útil
Erro generalizado no GitHub deixou repositórios, downloads e pipelines de CI/CD aos soluços. Mais um lembrete de como o open source depende de infra-estrutura proprietária.
Erro generalizado no GitHub deixou repositórios, downloads e pipelines de CI/CD aos soluços. Mais um lembrete de como o open source depende de infra-estrutura proprietária.
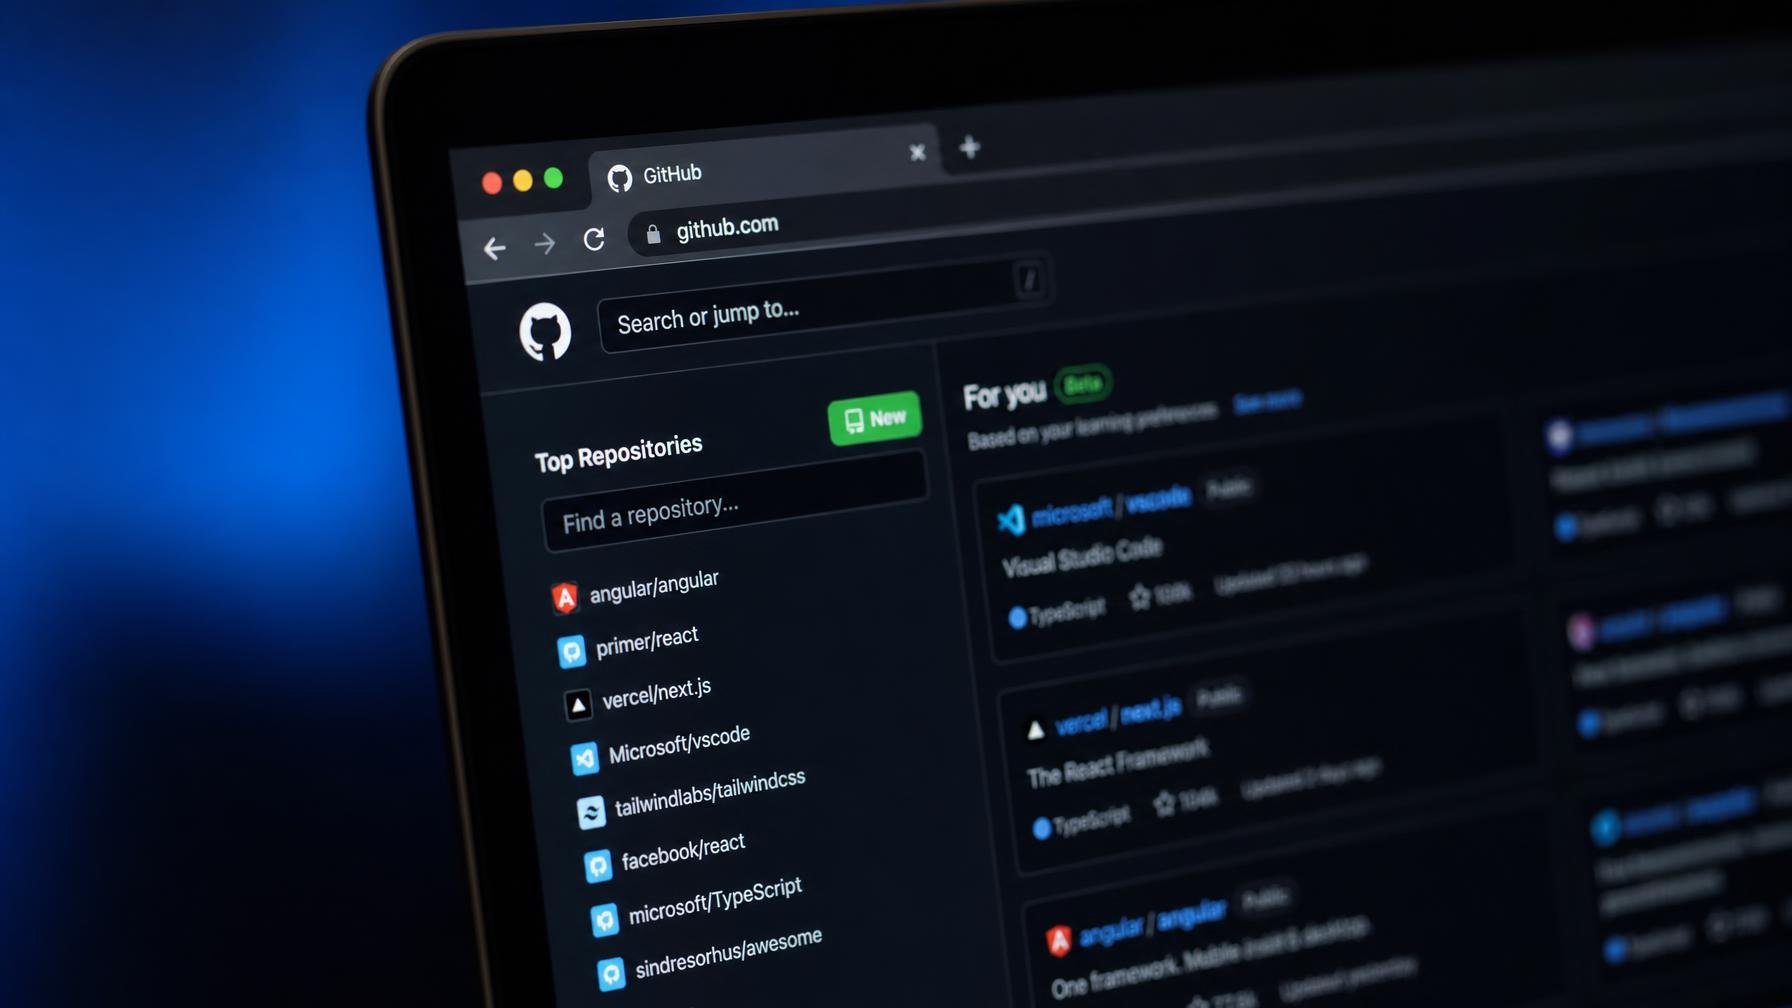
Quem ontem tentou fazer um git pull a meio da tarde mundial levou com o lado menos glamoroso da nuvem. O GitHub teve uma falha alargada em 17 de agosto de 2026 que afectou o site, a API, downloads de código e GitHub Actions, trazendo muita pipeline de CI/CD por aí abaixo.
Segundo a própria página de status do serviço, o GitHub começou a investigar o problema às 13h40 UTC, depois de um aumento claro nas taxas de erro. O tráfego web e da API andava com cerca de 20% de pedidos a falhar. Pior, os downloads de ficheiros de arquivo e de conteúdo bruto dos repositórios chegaram aos 50% de erros. Para quem gere deploys automatizados ou imagens de produção construídas a partir de repositórios públicos, isto é meio dia de trabalho deitado abaixo.
O impacto foi transversal. GitHub Actions ficou com desempenho degradado, o que significa builds, testes e deploys encravados ou a demorar uma eternidade. Houve relatos de dificuldades a carregar repositórios, commits e Pull Requests. Até os sistemas de autenticação empresarial como SAML, OIDC (OpenID Connect), SCIM (System for Cross-domain Identity Management) e Team Sync foram afectados, o que em muitas empresas simplesmente bloqueia o acesso à plataforma. Copilot também entrou na lista de serviços com disponibilidade degradada a partir das 14h31 UTC.
Curiosamente, nem tudo caiu. Operações Git básicas, Packages, Pages e Codespaces continuaram marcados como operacionais. Em teoria, quem estava a usar Git sobre SSH com mirrors próprios ainda se safou. Mas o normal em muitas equipas hoje é depender da interface web para Pull Requests, revisão de código e gestão de issues. Quando essa camada falha, não é “só” um serviço em baixo, é o fluxo de trabalho inteiro que fica em pausa. Este tipo de single point of failure lembra muito o caso recente em que documentos internos mal configurados acabaram indexados pelo Google: conforto e centralização têm um preço.
Até ao fecho da notícia, o GitHub ainda não tinha revelado a causa do incidente, limitando-se a dizer que a investigação estava em curso e que estavam a aplicar medidas de mitigação. O serviço de monitorização Downdetector registou milhares de queixas de utilizadores, o que encaixa com a escala global do GitHub. Para a maior parte dos projectos open source, especialmente os mais pequenos, não há plano B: o código está ali, as issues estão ali, o histórico de decisões está ali.
O episódio volta a expor a dependência do mundo open source de infra-estrutura proprietária de um único fornecedor. Repositórios, GitHub Actions e Pull Requests são hoje a espinha dorsal do acesso ao código, da integração contínua e da colaboração distribuída. Quando esse backbone pára, não é só “a Internet” que fica mais lenta, é a capacidade de lançar correções de segurança, de fazer releases e de manter serviços críticos a rodar. Quem anda a adiar mirrors em GitLab, instâncias auto-hospedadas ou backups regulares talvez tenha acabado de receber o lembrete mais persuasivo dos últimos meses.
Fonte: Open Source For You
Os routers gastam pouco, mas morrem ao mesmo tempo que as luzes. Com um pequeno inversor e baterias de ferramentas, podes ter internet durante horas num corte de…
Se apareceu um pequeno auscultador de telefone fixo na barra de estado do teu Android, quase de certeza é o Wi-Fi Calling. Explicamos o que significa, se vale…
O Gmail deixa-te desfazer o envio de emails por até 30 segundos, mas vem limitado a 5 por omissão. Há mais três definições que convém ajustar se passas…
Um jornalista do Android Police contou 50 toques extra em cinco dias só para escolher cartão. Duas definições já presentes no Android da Samsung quase eliminam os pedidos…
Comentários · 0