Novo teste mostra que a IA ainda vê o mundo bastante mal
O PerceptionBench, da chinesa Moonshot AI, separa visão de raciocínio e volta a expor um ponto cego da IA generativa: falha em tarefas visuais básicas, muito antes de pensar erradamente.
O PerceptionBench, da chinesa Moonshot AI, separa visão de raciocínio e volta a expor um ponto cego da IA generativa: falha em tarefas visuais básicas, muito antes de pensar erradamente.
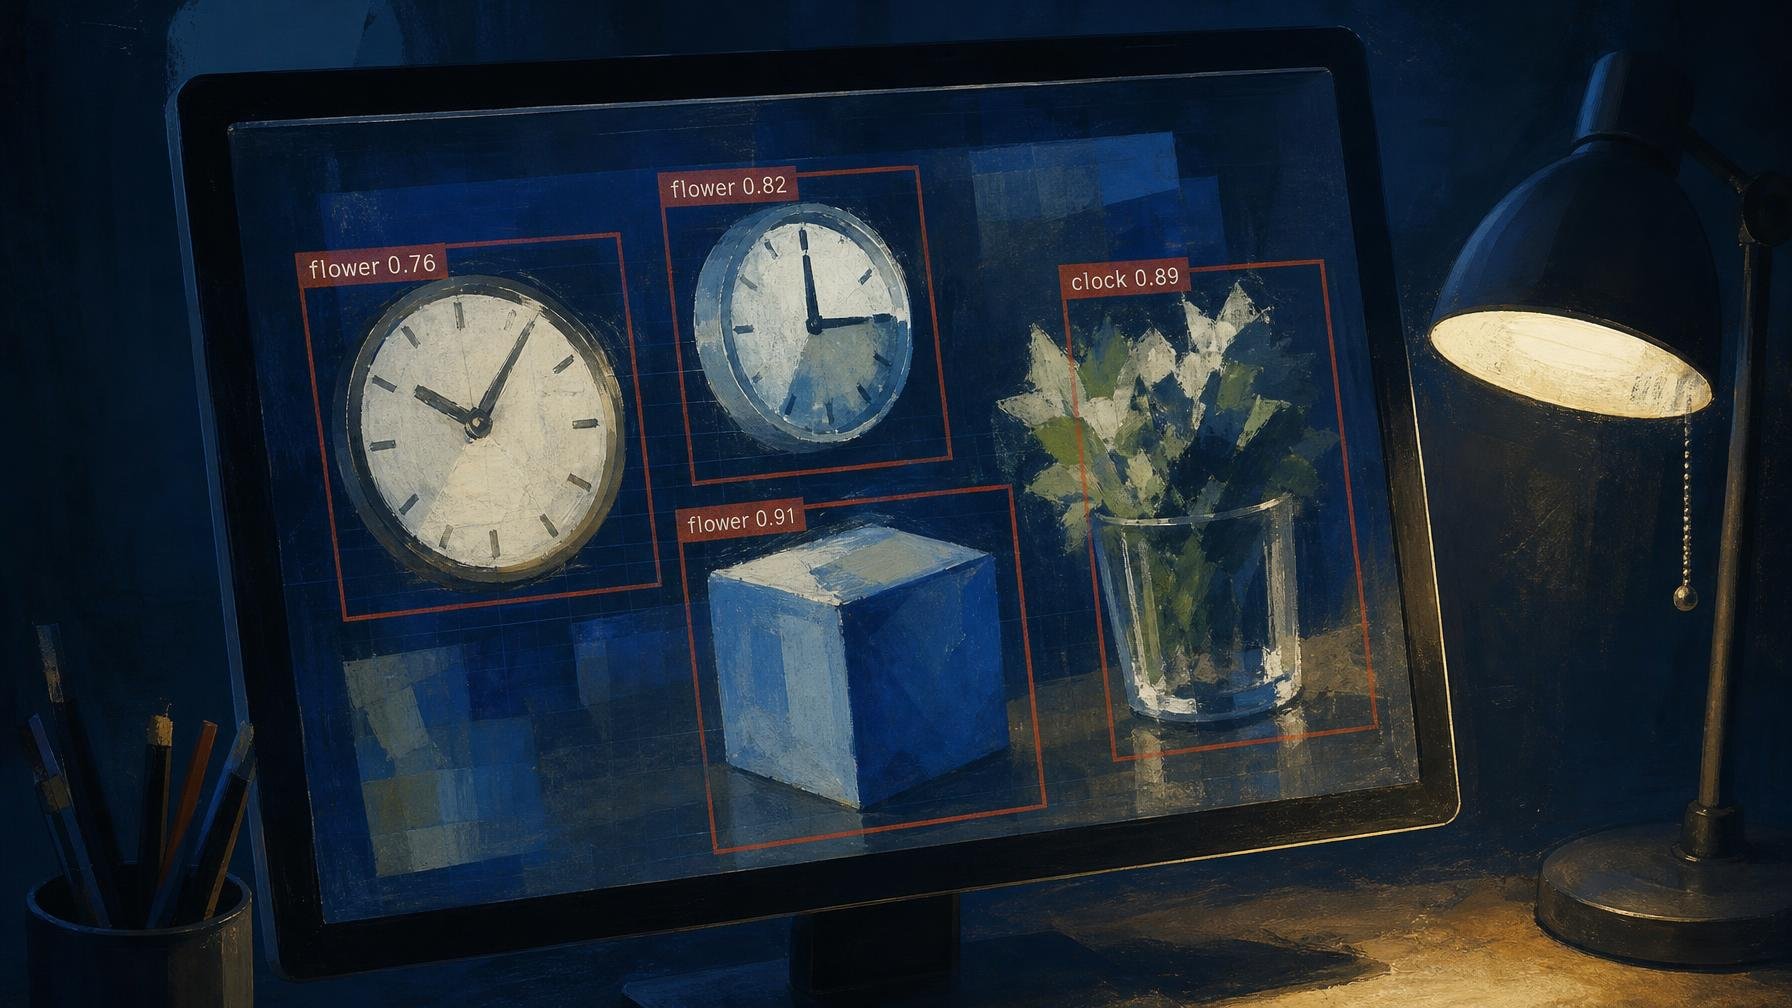
Os modelos de IA multimodal adoram vender-se como “olhos digitais” para tudo o que é imagem, vídeo ou slide. O PerceptionBench, novo benchmark da chinesa Moonshot AI, desmonta essa narrativa com um número simples: o melhor modelo do mundo não passa dos 60 por cento de acerto em tarefas visuais básicas. Isto não é falhar em física quântica, é falhar a contar flores dentro de um quadrado vermelho.
A equipa da Moonshot, conhecida pelo assistente Kimi que anda a apertar a concorrência na China, decidiu separar o que quase todos os outros testes misturam: percepção visual, conhecimento e raciocínio. No PerceptionBench, cada pergunta pode ser respondida só a olhar para a imagem, sem contexto externo. Nada de perguntas encadeadas, nada de “pensa passo a passo”. A ideia é identificar o momento exato em que o modelo se engana: logo a ler o ecrã, a localizar um objeto, a perceber profundidade, ou mais tarde, no raciocínio.
Para chegar lá, analisaram 42 benchmarks abertos e perceberam que praticamente não se sobrepunham em tipos de erro. Cada teste cobria o seu nicho de falhanços, mas ninguém tinha um mapa global da percepção visual. Em vez de inventar categorias de secretária, a Moonshot fez o caminho inverso: partiu de erros reais, rastreou-os até ao primeiro passo falhado, e daí construiu dez domínios de “skills” visuais, como Relação Visual, Contagem, Atributos, Profundidade & 3D, Localização, Comparação, Reconhecimento fino, Integração de contexto, OCR e Alucinação.
Do lado dos números, o retrato é pouco simpático para quem anda a vender IA como olho clínico universal. Entre 16 modelos de topo testados, o melhor é o GPT-5.6 Sol, com 59,7 por cento de acerto. Logo atrás surgem Kimi K3, Claude Fable 5 e Gemini 3.1 Pro, todos separados por menos de quatro pontos. Modelos abertos de grande escala, como Qwen3.5-397B-A17B, ficam bem abaixo dos 50 por cento, e outros como GLM-4.6V afundam-se na casa dos 30 e poucos. Ou seja, em média, uma moeda ao ar não está assim tão distante de alguns modelos quando o desafio é perceber o que está diante dos “olhos”.
Mais interessante que a tabela geral é o perfil de fraquezas por categoria. Modelos com pontuações globais quase idênticas podem divergir brutalmente em tarefas específicas. Em média, o pior domínio é o de alucinação, a mania de ver objetos que não existem. O mesmo GPT-5.6 Sol que lidera o ranking geral cai para 26,9 por cento neste sub-teste, enquanto um modelo teoricamente mais fraco, como o Gemini 3.5 Flash, chega aos 50,6 por cento. Aqui a pergunta certa é, muitas vezes, “quantos objetos vês?”, e a resposta correta é “zero”. Os modelos continuam a insistir em arranjar qualquer coisa para dizer, um padrão que já vimos na corrida armamentista entre OpenAI, Anthropic e gigantes chinesas como a própria Moonshot, onde a pressão para responder rápido e com confiança raramente puxa pela prudência.
A conclusão mais incómoda do estudo é esta: muitos erros que andam a ser classificados como “falhas de raciocínio” são, afinal, erros de visão logo à partida. Se o modelo lê mal a imagem, todo o raciocínio a seguir é lixo bem articulado. Para quem usa estes sistemas em medicina, indústria, cidades inteligentes ou simplesmente para validar PDFs e screenshots no trabalho, isto devia ser um travão saudável ao entusiasmo. A IA entende cada vez melhor texto, mas continua a tropeçar no óbvio quando olha para o mundo. Confiar cegamente nesta visão borrada é pedir problemas, e o PerceptionBench faz o favor de pôr isso por escrito.
Fonte: The Decoder

Os primeiros Nest Learning Thermostat perderam funções ligadas à cloud em 2025 e ficaram reduzidos ao básico. Um projeto open source devolve-lhes agendamento remoto, integrações e um pouco…

A fuga não é só por causa da IA do Copilot. Há uma lista crescente de queixas e alternativas maduras para onde comunidades inteiras estão a migrar.

Mapas de divisão, câmaras, microfones e cloud transformaram os aspiradores‑robô em sensores ambulantes. O problema não é só técnico, é de modelo de negócio e de políticas de…

Os novos óculos inteligentes da HTC fazem quase o mesmo que os de Meta, mas trocam a sede de dados por limites claros: IA sem login, vídeos cifrados…
Comentários · 0