WikiSkill da Google dá memória duradoura a agentes de IA
A Google propõe um wiki interno para agentes de IA aprenderem com erros passados sem tocar no modelo base. É truque de bastidores, mas mexe nos números de desempenho.
A Google propõe um wiki interno para agentes de IA aprenderem com erros passados sem tocar no modelo base. É truque de bastidores, mas mexe nos números de desempenho.
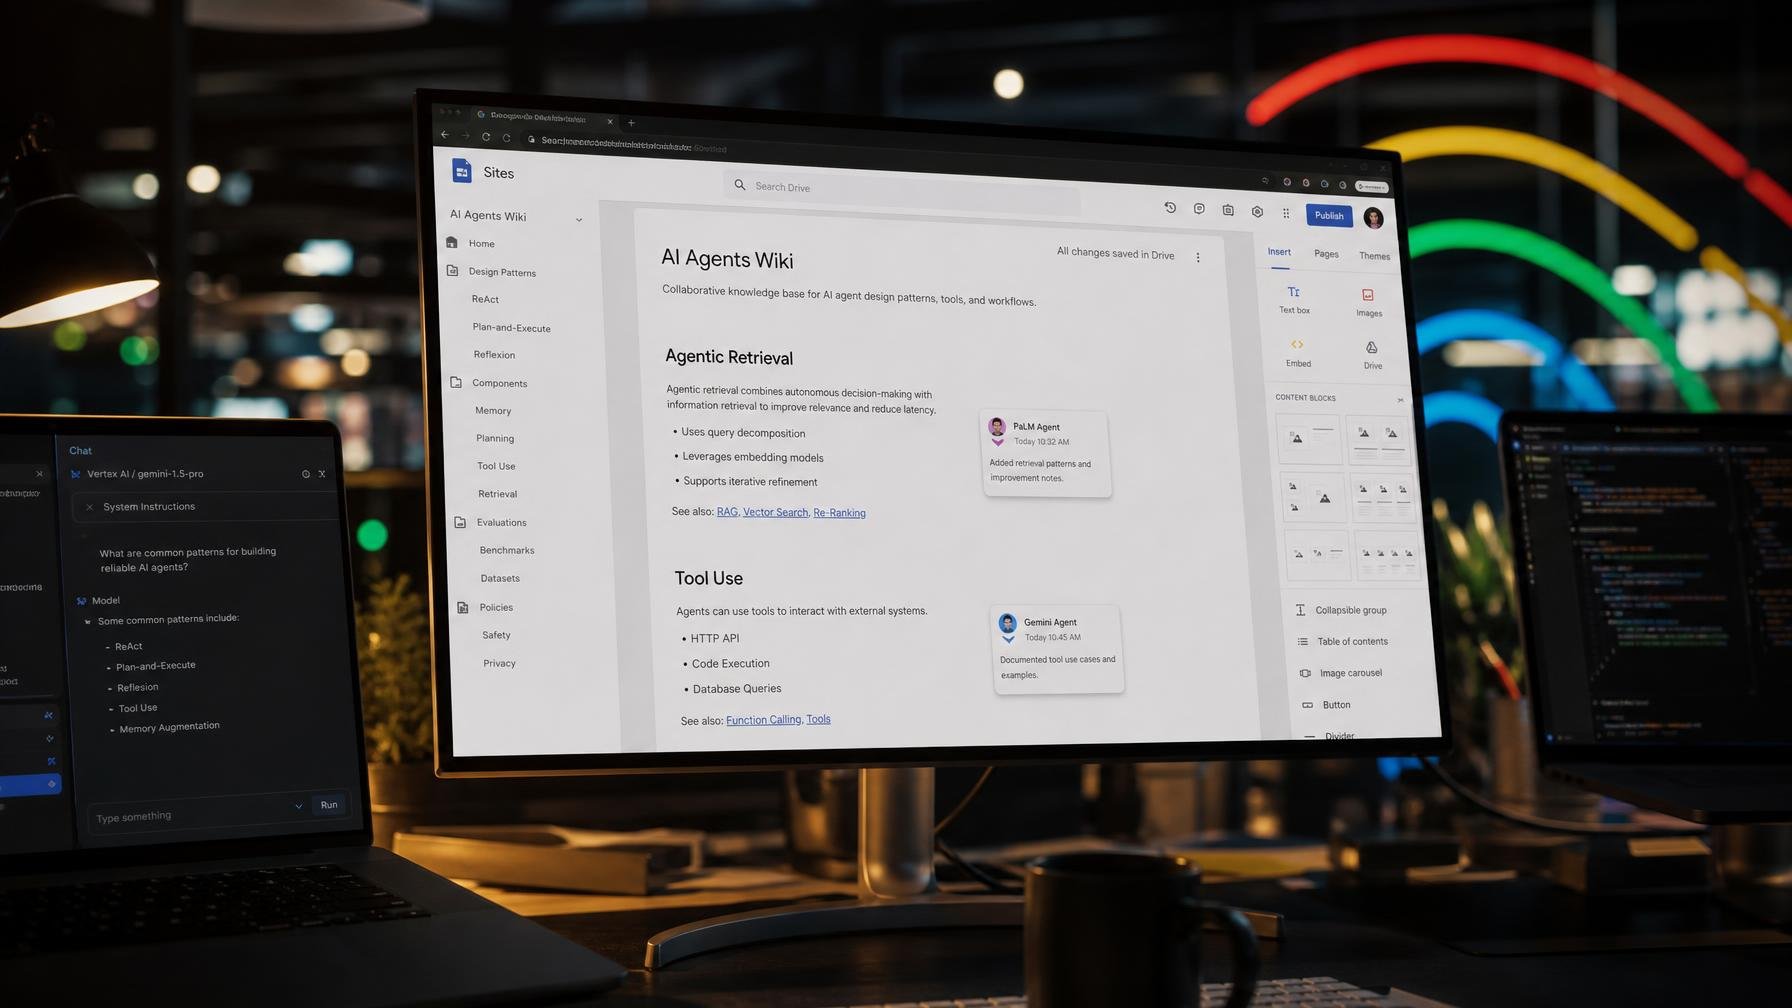
Em vez de treinar modelos cada vez maiores e rezar para que acertem mais vezes, a Google Research anda a mexer noutro sítio: no que acontece depois de cada execução. Chama-se WikiSkill e é, na prática, um wiki privado onde os agentes de IA guardam aquilo que correu mal e bem, para ajustarem o comportamento em futuras tentativas.
Importa esclarecer logo: o modelo não passa a aprender de forma contínua no sentido clássico, o tal problema em aberto no mundo da IA. O que muda é a camada à volta. Depois de cada run, o sistema escreve melhores instruções para o próprio agente, empacotadas em “Agent Skills”, módulos reutilizáveis que orientam o comportamento sem alterar pesos do modelo. É quase como dar a um estagiário um manual interno que vai sendo anotado, em vez de o mandar, de novo, aprender tudo do zero.
O WikiSkill divide o processo em três camadas. Na base, a “Raw Layer” guarda o rasto completo da execução: chamadas a ferramentas, resultados, sequência de passos. Nada aqui se apaga. Em cima está a “Wiki Layer”, onde um componente chamado “Wiki Maintainer” destila esse caos em conhecimento estruturado: padrões de falha documentados, estratégias que funcionaram, armadilhas a evitar. Esta wiki é persistente e só cresce. No topo está a “Skill Layer”, o conjunto de instruções activas que o agente segue quando trabalha. Estas sim podem ser revertidas se uma alteração piorar o desempenho.
O ciclo é relativamente simples: o agente executa tarefas com as skills actuais, gera traços de execução, o Wiki Maintainer analisa, escreve para o wiki, e um “Skill Proposer” usa esse conhecimento para sugerir novas skills ou ajustes. Antes de entrarem em produção, essas skills passam por um mecanismo de validação separado. Se ajudarem, ficam. Se não, voltam atrás, mas o wiki continua lá, a registar inclusive as tentativas falhadas. É engenharia de processo aplicada à IA: não há magia, há versionamento, rollback e documentação compulsiva.
Nos testes, a Google usou modelos como Qwen (4B, 9B, 27B), Gemma-4-31B e Gemini-3.5-Flash, em cinco benchmarks que vão de problemas de matemática a pesquisa na web, folhas de cálculo e ambientes interactivos. Com WikiSkill, o Gemini-3.5-Flash sobe em média de 49,5% para 68,1% de desempenho, e o Qwen-3.6-27B salta de 39,4% para 63,3%. Em tarefas como LiveMath ou SpreadSheet, os ganhos são ainda mais agressivos, com saltos de cerca de 30 a 40 pontos percentuais. Por contraste, tarefas com contextos longos de documentos praticamente não mexem, o que mostra bem onde está o limite deste truque.
Há duas leituras interessantes para quem está em Portugal a montar sistemas com modelos open source ou a pagar APIs de IA em dólares. Primeiro, modelos pequenos com WikiSkill aproximam-se do desempenho de modelos maiores sem o framework. Em contexto de custos de GPU a subir, como já se nota nos servidores de IA da Nvidia, isto é munição para quem quer fazer mais com menos. Segundo, skills desenvolvidas por um modelo podem ser transferidas para outro e, por vezes, até funcionam melhor do que as skills que esse segundo modelo geraria sozinho. Claro que não é garantido, a equipa sublinha que a transferibilidade tem de ser testada caso a caso.
No fundo, a Google está a formalizar o que muitas equipas já fazem à mão quando ajustam prompts, escrevem playbooks internos e colam exemplos em wikis corporativos. A diferença é que aqui esse trabalho é sistemático, automatizado e versionado. Não resolve o problema de aprendizagem contínua, não torna os modelos mais conscientes, nem substitui treino sério com dados novos. Mas mostra que há muito rendimento escondido na camada de orquestração, precisamente onde quem anda a correr chatbots de IA em casa ou em pequenas empresas tem mais margem para experimentar.
Fonte: The Decoder
Os resumos de IA do Google continuam a meter ruído nos resultados de muita gente. Há duas formas simples de os contornar e voltar aos velhos links azuis.
A comunidade open source pegou em apps e mostradores dos Galaxy Watch e levou-os para o Pixel Watch. Há um truque: tudo passa por sideloading e algum à-vontade…
O Android 17 finalmente traz janelas flutuantes para qualquer app, mas a solução da Google é limitada e confusa. A abordagem da Samsung mostra como o multitasking móvel…
Todas as televisões com Google TV deixam de receber atualizações ao fim de alguns anos, mas a data não é óbvia. Há um menu escondido que mostra quanto…
Comentários · 0